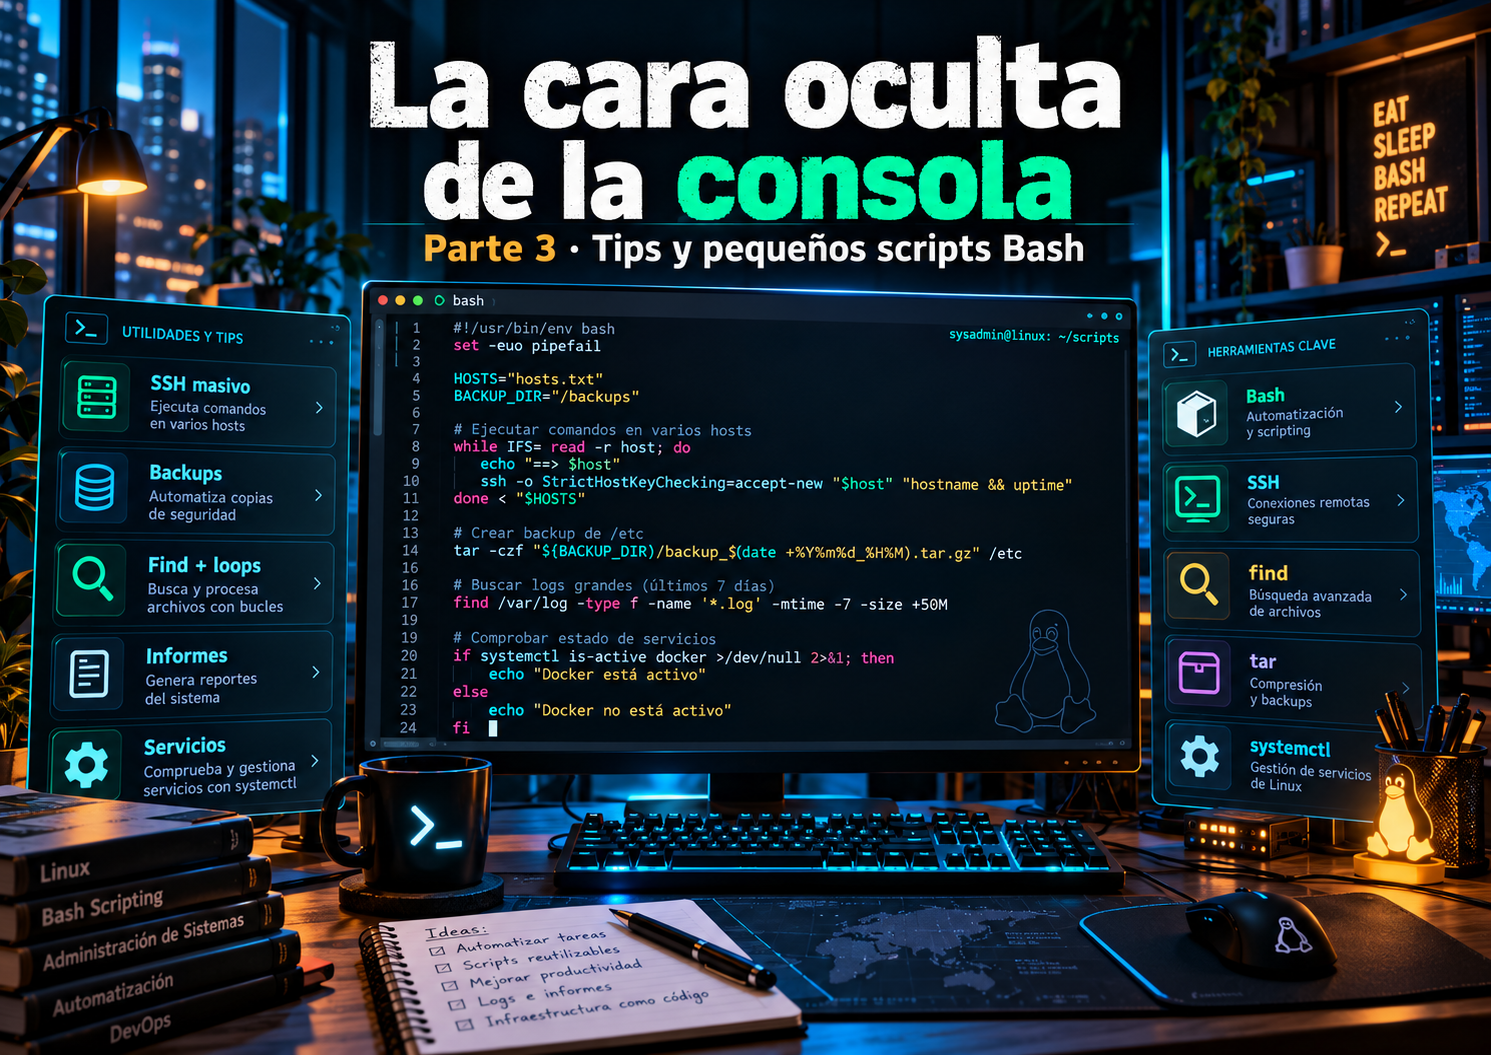
Automatizar conexiones SSH, recorrer archivos, crear backups, comprobar servidores y resolver tareas cotidianas con unas pocas líneas de Bash.
Hay una cosa que me gusta especialmente de Linux: muchas veces no necesitamos desarrollar una aplicación completa para resolver un problema. Un pequeño script de cinco o diez líneas puede ahorrarnos mucho trabajo.
Y lo mejor es que, en ocasiones, descubrimos estas posibilidades por casualidad.
Por ejemplo, cuando preparo un laboratorio con varios servidores Linux, una de las primeras cosas que necesito es establecer las conexiones SSH.
Podría conectarme manualmente a cada servidor para aceptar su clave pública de identidad, pero ¿qué ocurre si tengo diez, veinte o cincuenta máquinas?
¿Y si los servidores están definidos en un archivo de texto?
¿Podría recorrer ese archivo y realizar la operación automáticamente?
Por supuesto. Y ese es precisamente el tipo de ejemplos que quiero compartir en esta tercera entrega.
Vamos a combinar comandos habituales con bucles, condiciones, variables y pequeñas funciones de Bash. No hace falta dominar la programación de scripts, aunque sí conviene conocer los fundamentos de la terminal.
Todos los ejemplos están pensados para poder modificarlos y adaptarlos a nuestras necesidades.
1. Preparar conexiones SSH a varios servidores
Empecemos por el ejemplo que me dio la idea para este artículo.
Imaginemos que tenemos un laboratorio con cinco servidores:
debian2
rocky1
rocky2
alpine1
mysql1
Podemos recorrerlos y ejecutar una conexión SSH:
for host in debian2 rocky1 rocky2 alpine1 mysql1; do
    ssh -o StrictHostKeyChecking=accept-new \
        -i ~/.ssh/ansible_lab_ed25519 \
        ansible@"$host" true
done
Pero ¿qué estamos haciendo exactamente?
La opción StrictHostKeyChecking=accept-new permite que SSH incorpore automáticamente las claves de identidad de servidores desconocidos a nuestro archivo ~/.ssh/known_hosts.
Si un servidor ya conocido presenta una clave diferente, SSH rechazará la conexión.
La opción -i indica qué clave privada utilizar para autenticarnos.
Y true es el comando remoto. No genera ninguna salida y termina correctamente.
Hay dos detalles que conviene aclarar:
Primero, este procedimiento no copia nuestra clave pública al servidor. Para eso existe, por ejemplo,
ssh-copy-id.Segundo, aceptar automáticamente la identidad de un servidor desconocido implica confiar en la clave presentada durante esa primera conexión. En entornos sensibles debemos verificar previamente su huella digital mediante un canal de confianza.
Mejorándolo: servidores desde un archivo
En lugar de escribir los nombres dentro del script, vamos a crear un archivo servidores.txt:
# Servidores del laboratorio
debian2
rocky1
rocky2
alpine1
mysql1
Y ahora utilizaremos:
#!/usr/bin/env bash

ARCHIVO="servidores.txt"
CLAVE="$HOME/.ssh/ansible_lab_ed25519"

while IFS= read -r host || [[ -n "$host" ]]; do
    [[ -z "$host" || "$host" == \#* ]] && continue

    echo "Preparando SSH para: $host"

    ssh -n \
        -o StrictHostKeyChecking=accept-new \
        -o BatchMode=yes \
        -o ConnectTimeout=5 \
        -i "$CLAVE" \
        "ansible@$host" true

done < "$ARCHIVO"
Aquí aparecen varias cosas interesantes:
while readlee el archivo línea por línea.IFS=evita que se eliminen espacios durante la lectura.-rimpide quereadinterprete las barras invertidas como escapes.[[ -z "$host" ]]descarta líneas vacías."$host" == \#*permite ignorar comentarios.ssh -nevita que SSH consuma la entrada estándar utilizada por el bucle.BatchMode=yesimpide solicitar contraseñas interactivamente.ConnectTimeout=5limita el tiempo de establecimiento de la conexión.
La condición || [[ -n "$host" ]] también permite procesar una última línea que no termine con salto de línea.
Este script supone que la autenticación por clave ya funciona. Si no funciona, la conexión puede fallar aunque se haya registrado la clave de identidad del servidor.
¿Cuándo lo utilizo?
Cuando preparo laboratorios de Ansible, despliego máquinas nuevas o necesito inicializar conexiones SSH a varios equipos bajo mi administración.
2. Comprobar qué servidores SSH están disponibles
Ya tenemos nuestro archivo servidores.txt.
Ahora podemos reutilizarlo para comprobar qué servidores aceptan conexiones SSH.
#!/usr/bin/env bash

ARCHIVO="servidores.txt"
CLAVE="$HOME/.ssh/ansible_lab_ed25519"

while IFS= read -r host || [[ -n "$host" ]]; do
    [[ -z "$host" || "$host" == \#* ]] && continue

    if ssh -n \
        -o BatchMode=yes \
        -o StrictHostKeyChecking=yes \
        -o ConnectTimeout=5 \
        -i "$CLAVE" \
        "ansible@$host" true 2>/dev/null; then

        echo "[OK] $host"

    else
        echo "[ERROR] $host"
    fi

done < "$ARCHIVO"
Aquí utilizamos StrictHostKeyChecking=yes porque suponemos que ya hemos registrado y verificado las identidades de nuestros servidores.
De esta forma evitamos aceptar nuevas claves durante una simple comprobación de disponibilidad.
Una salida posible:
[OK] debian2
[OK] rocky1
[ERROR] rocky2
[OK] alpine1
[OK] mysql1
El resultado OK indica que hemos conseguido autenticarnos y ejecutar correctamente el comando remoto.
En cambio, ERROR puede deberse a problemas de red, autenticación, resolución de nombres o configuración SSH.
No significa necesariamente que el servidor esté apagado.
¿Cuándo lo utilizo?
Antes de ejecutar tareas de mantenimiento o desplegar configuraciones a varios servidores.
3. Ejecutar un comando en varios servidores y guardar los resultados
Vamos a mejorar el ejemplo anterior: Imaginemos que queremos conocer el hostname, la versión del kernel y el tiempo de actividad de nuestros servidores.
Podríamos conectarnos manualmente a cada uno, pero vamos a automatizarlo:
#!/usr/bin/env bash

ARCHIVO="servidores.txt"
CLAVE="$HOME/.ssh/ansible_lab_ed25519"
REPORTE="informe_servidores.txt"

: > "$REPORTE"

while IFS= read -r host || [[ -n "$host" ]]; do
    [[ -z "$host" || "$host" == \#* ]] && continue

    echo "Consultando $host..."

    {
        printf '\n===== %s =====\n' "$host"

        ssh -n \
            -o BatchMode=yes \
            -o StrictHostKeyChecking=yes \
            -o ConnectTimeout=5 \
            -i "$CLAVE" \
            "ansible@$host" \
            'hostname; uname -r; uptime -p'

    } >> "$REPORTE" 2>&1

done < "$ARCHIVO"

echo "Informe generado: $REPORTE"
Este ejemplo incorpora una construcción interesante:
{
    comando1
    comando2
} >> archivo.txt
Las llaves agrupan instrucciones y permiten redirigir toda su salida al mismo archivo.
El operador >> añade contenido sin sobrescribir lo que ya existe.
Y 2>&1 hace que los mensajes de error también se incorporen al informe.
Por último:
: > "$REPORTE"
Vacía el archivo al comenzar, o lo crea si no existe.
El carácter : es un comando integrado de Bash que no realiza ninguna acción y devuelve un estado correcto.
¿Cuándo lo utilizo?
Para generar pequeños inventarios, recopilar datos de sistemas o revisar varios servidores sin conectarme manualmente a cada uno.
4. Recorrer un directorio y procesar todos sus archivos
Otra tarea muy habitual es recorrer directorios.
Imaginemos que tenemos una carpeta con archivos .log y queremos mostrar el tamaño de cada uno.
Podemos utilizar:
#!/usr/bin/env bash

DIRECTORIO="/var/log"

for archivo in "$DIRECTORIO"/*.log; do
    [[ -f "$archivo" ]] || continue

    echo "Archivo: $archivo"
    du -h "$archivo"
done
El patrón *.log selecciona los nombres que terminan con esa extensión dentro del directorio.
La condición:
[[ -f "$archivo" ]] || continue
comprueba que el elemento sea un archivo normal y evita procesarlo si no existe ningún archivo coincidente.
Este mecanismo también funciona con nombres que contienen espacios, porque hemos utilizado comillas alrededor de la variable.
¿Y si necesitamos recorrer subdirectorios?
Podemos combinar find con while:
find /var/log -type f -name "*.log" -print0 |
while IFS= read -r -d '' archivo; do
    echo "Procesando: $archivo"
done
Esta forma es más robusta para nombres de archivo especiales.
-print0 separa las rutas utilizando un carácter nulo.
Y read -d '' interpreta ese carácter como delimitador.
Así evitamos problemas con espacios o saltos de línea dentro de los nombres.
¿Cuándo lo utilizo?
Para procesar logs, convertir archivos, revisar configuraciones o automatizar operaciones dentro de proyectos.
5. Renombrar cientos de archivos automáticamente
Supongamos que tenemos fotografías con nombres como:
foto1.jpg
foto2.jpg
foto3.jpg
Y queremos añadirles un prefijo:
vacaciones_foto1.jpg
vacaciones_foto2.jpg
vacaciones_foto3.jpg
Podemos hacerlo con:
#!/usr/bin/env bash

DIRECTORIO="./fotos"

for archivo in "$DIRECTORIO"/*.jpg; do
    [[ -f "$archivo" ]] || continue

    nombre=$(basename "$archivo")

    echo "Renombrar: $nombre -> vacaciones_$nombre"

done
De momento, el script solamente muestra las operaciones.
Esto es una buena práctica: comprobar primero qué cambiará antes de modificar los archivos.
Cuando estemos seguros, podemos reemplazar el echo por:
mv -n -- "$archivo" "$DIRECTORIO/vacaciones_$nombre"
La opción -n evita sobrescribir un archivo que ya existe en el destino.
El operador -- indica el final de las opciones, evitando problemas si el nombre de un archivo comienza por un guion.
Un truco adicional: eliminar extensiones
nombre="documento.pdf"

echo "${nombre%.*}"
Resultado:
documento
La expresión ${nombre%.*} elimina desde el final la coincidencia más corta del patrón .*.
Es una característica del propio Bash conocida como expansión de parámetros.
¿Cuándo lo utilizo?
Para organizar fotografías, normalizar nombres y preparar lotes de archivos para su procesamiento.
6. Crear backups automáticos con fecha y hora
Este es uno de los scripts que casi siempre resulta útil tener preparado.
Imaginemos que queremos crear un backup de un proyecto:
#!/usr/bin/env bash
set -euo pipefail

ORIGEN="$HOME/proyectos/portfolio"
DESTINO="$HOME/backups"

FECHA=$(date +%Y%m%d_%H%M%S)

mkdir -p "$DESTINO"

tar -czf \
    "$DESTINO/portfolio_$FECHA.tar.gz" \
    -C "$(dirname "$ORIGEN")" \
    "$(basename "$ORIGEN")"

echo "Backup creado correctamente"
Una posible salida:
portfolio_20261025_173000.tar.gz
¿Qué hace cada parte?
date +%Y%m%d_%H%M%S genera una marca temporal que podemos utilizar en nombres de archivo.
mkdir -p asegura que exista el directorio de destino.
tar -czf crea un archivo comprimido con gzip.
La opción -C cambia el directorio desde el que tar interpreta las rutas de origen.
Y:
set -euo pipefail
activa varias comprobaciones útiles en Bash:
-e: solicita terminar ante determinados errores de comandos.-u: considera un error utilizar variables que no estén definidas.pipefail: permite detectar fallos dentro de tuberías, en lugar de considerar únicamente el último comando.
Estas opciones ayudan, pero no sustituyen una gestión explícita de errores. set -e, por ejemplo, tiene excepciones en condiciones y determinadas construcciones del shell.
El script también supone que el directorio de origen existe y es accesible.
¿Cuándo lo utilizo?
Antes de modificar proyectos, actualizar aplicaciones o realizar tareas de mantenimiento.
Para backups de aplicaciones con bases de datos activas, necesitamos además procedimientos que garanticen la consistencia de los datos.
7. Conservar únicamente los últimos backups
Crear copias de seguridad es necesario, pero también debemos controlar cuánto espacio ocupan.
Supongamos que generamos backups diarios y queremos conservar solamente los diez más recientes:
#!/usr/bin/env bash

DESTINO="$HOME/backups"

mapfile -d '' -t archivos < <(
    find "$DESTINO" -maxdepth 1 -type f \
        -name 'portfolio_*.tar.gz' \
        -printf '%T@ %p\0' |
    sort -zrn |
    cut -z -d' ' -f2-
)

for ((i=10; i<${#archivos[@]}; i++)); do
    printf 'Eliminar backup antiguo: %s\n' "${archivos[$i]}"
done
Este script todavía no elimina nada. Solo muestra qué archivos quedarían fuera de los diez más recientes.
Aquí encontramos varias técnicas interesantes:
mapfilepermite cargar datos en un array de Bash.find -printf '%T@ %p\0'genera registros con la fecha de modificación y la ruta, separados por caracteres nulos.sort -zrnlos ordena numéricamente en orden descendente, conservando los registros delimitados por nulos.cut -zelimina el campo de fecha y conserva el nombre completo.
Y el bucle:
for ((i=10; i<${#archivos[@]}; i++))
recorre los elementos a partir del índice 10, es decir, después de los diez primeros.
Cuando hayamos verificado el resultado, podemos sustituir el printf por:
rm -i -- "${archivos[$i]}"
Conviene conservar copias externas y una política de retención adecuada. Los últimos diez archivos no sustituyen una estrategia de backup.
¿Cuándo lo utilizo?
Para controlar el crecimiento de backups locales o automatizados.
8. Buscar archivos modificados durante las últimas 24 horas
Este ejemplo es especialmente útil cuando investigamos cambios recientes en un servidor:
#!/usr/bin/env bash

DIRECTORIO="/etc"

find "$DIRECTORIO" \
    -type f \
    -mmin -1440 \
    -printf '%TY-%Tm-%Td %TH:%TM %p\n'
-mmin -1440 busca archivos modificados durante los últimos 1440 minutos, equivalentes a 24 horas.
La opción -printf permite mostrar la fecha y la ruta.
Podemos ampliar la búsqueda a otros directorios, siempre que tengamos los permisos necesarios.
¿Y si queremos detectar cambios de permisos?
Linux mantiene varias marcas temporales para cada archivo. Dos de las más interesantes son:
mtime(modification time): indica cuándo se modificó por última vez el contenido del archivo.ctime(change time): indica cuándo cambió por última vez el estado del inodo, por ejemplo, al modificar permisos, propietario o contenido.
Aunque se llama ctime, no significa creation time. No representa la fecha de creación del archivo.
Para localizar archivos cuyo ctime haya cambiado durante las últimas 24 horas, podemos utilizar:
find /etc -type f -cmin -1440
La opción -cmin consulta el atributo ctime utilizando minutos como unidad.
También podemos utilizar -ctime para trabajar con períodos expresados en días:
find /etc -type f -ctime -1
Y si queremos ver la fecha exacta del último cambio de estado:
find /etc -type f \
    -printf '%CY-%Cm-%Cd %CH:%CM:%CS %p\n'
Una precaución: un cambio de ctime no demuestra que alguien haya modificado los permisos. También puede deberse a una modificación del contenido, del propietario o de otros metadatos. Para saber exactamente qué cambió necesitamos información adicional, como registros de auditoría o una copia anterior de los metadatos.
Por tanto, no representa exclusivamente cambios de permisos.
¿Cuándo lo utilizo?
Durante auditorías, revisiones de configuraciones o investigaciones después de detectar comportamientos inesperados.
9. Comprobar el estado de varios servicios systemd
Supongamos que queremos saber si varios servicios están activos.
En lugar de consultar uno por uno:
systemctl status sshd
systemctl status docker
systemctl status nginx
Podemos recorrer una lista.
#!/usr/bin/env bash

SERVICIOS=("sshd" "docker" "nginx")

for servicio in "${SERVICIOS[@]}"; do

    if systemctl is-active --quiet "$servicio"; then
        echo "[OK] $servicio"
    else
        echo "[ERROR] $servicio"
    fi

done
La expresión:
"${SERVICIOS[@]}"
recorre los elementos del array por separado, conservando cada elemento como un argumento.
Y:
systemctl is-active --quiet
permite utilizar el código de salida del comando sin imprimir su resultado.
Los nombres de las unidades pueden cambiar entre distribuciones. Por ejemplo, el servicio SSH puede llamarse ssh.service o sshd.service.
¿Cuándo lo utilizo?
Para crear comprobaciones rápidas después de reinicios, actualizaciones o mantenimientos.
10. Comprobar si un puerto TCP está disponible
En ocasiones necesitamos saber si podemos establecer una conexión TCP hacia un servidor.
Bash dispone de un mecanismo interesante mediante /dev/tcp.
#!/usr/bin/env bash

HOST="192.168.1.100"
PUERTO=22

if timeout 3 bash -c \
    'echo > /dev/tcp/"$1"/"$2"' _ "$HOST" "$PUERTO" 2>/dev/null; then

    echo "[OK] Puerto $PUERTO accesible en $HOST"

else
    echo "[ERROR] No se pudo conectar"
fi
/dev/tcp es una característica especial de Bash y no un directorio real que necesite existir en el sistema de archivos.
Cuando la shell admite esta función, intenta abrir una conexión TCP a la dirección y puerto indicados.
timeout 3 evita que la operación se prolongue más de lo previsto.
Es una comprobación sencilla, pero tiene una limitación: conseguir conectar a un puerto no demuestra que el servicio funcione correctamente a nivel de aplicación.
Por ejemplo, podríamos conectar al puerto 443 y que el servidor HTTPS devolviera errores en todas sus peticiones.
¿Cuándo lo utilizo?
Para comprobar conectividad básica cuando no tengo disponibles herramientas como nc.
11. Generar un informe rápido del estado del servidor
Vamos a combinar varios comandos para generar un pequeño informe:
#!/usr/bin/env bash

REPORTE="estado_$(hostname)_$(date +%Y%m%d).txt"

{
    echo "===== INFORME DEL SISTEMA ====="
    date

    echo
    echo "===== HOSTNAME ====="
    hostname

    echo
    echo "===== KERNEL ====="
    uname -r

    echo
    echo "===== UPTIME ====="
    uptime -p

    echo
    echo "===== MEMORIA ====="
    free -h

    echo
    echo "===== DISCOS ====="
    df -hT

    echo
    echo "===== SERVICIOS FALLIDOS ====="
    systemctl --failed --no-pager

    echo
    echo "===== PUERTOS TCP EN ESCUCHA ====="
    ss -lnt

} > "$REPORTE"

echo "Informe guardado en $REPORTE"
Fijémonos en que no necesitamos una herramienta de monitorización completa para obtener una fotografía rápida del sistema.
Podemos ampliar el informe con más comandos o ejecutarlo periódicamente mediante un temporizador de systemd.
El informe muestra el estado observado en ese momento. No es una monitorización continua.
¿Cuándo lo utilizo?
Antes y después de mantenimientos, actualizaciones o intervenciones en servidores.
12. Comparar dos archivos y detectar cambios
Supongamos que queremos modificar una configuración, pero antes necesitamos comprobar qué ha cambiado respecto a una copia anterior.
Podemos utilizar:
diff -u configuracion.conf.bak configuracion.conf
La opción -u muestra las diferencias en formato unificado.
Pero podemos ir un poco más lejos y comparar el contenido de dos directorios:
diff -qr directorio_original directorio_nuevo
Aquí:
-q: informa únicamente de si los archivos difieren.-r: recorre los subdirectorios.
Comparar dos listas sin importar el orden
diff -u \
    <(sort lista_antigua.txt) \
    <(sort lista_nueva.txt)
Estamos utilizando sustitución de procesos.
Bash ejecuta ambos comandos sort y presenta sus salidas a diff como si fueran archivos.
Hay que tener en cuenta que este ejemplo mantiene las entradas repetidas. Si queremos comparar conjuntos de líneas sin duplicados, podemos utilizar sort -u.
¿Cuándo lo utilizo?
Para comparar inventarios, configuraciones, versiones de proyectos y resultados de comandos.
13. Ejecutar tareas en paralelo y controlar cuántas hay activas
Normalmente, un bucle ejecuta sus instrucciones secuencialmente.
Pero podemos lanzar tareas en segundo plano utilizando &.
Por ejemplo:
#!/usr/bin/env bash

for numero in {1..5}; do
    (
        echo "Iniciando tarea $numero"
        sleep 3
        echo "Terminando tarea $numero"
    ) &
done

wait

echo "Todas las tareas han finalizado"
Cada grupo entre paréntesis se ejecuta en una subshell.
El símbolo & permite ejecutar la operación en segundo plano.
Y wait espera a que terminen los trabajos pendientes.
Limitar el número de tareas
Bash también permite controlar la concurrencia.
#!/usr/bin/env bash

MAX=3
activas=0

for numero in {1..10}; do

    (
        echo "Procesando tarea $numero"
        sleep 2
    ) &

    ((++activas))

    if (( activas >= MAX )); then
        wait
        activas=0
    fi

done

wait
echo "Procesamiento finalizado"
Este ejemplo trabaja por grupos de tres tareas.
No es un gestor completo de trabajos: espera a que termine todo el grupo antes de lanzar el siguiente y no comprueba individualmente los códigos de salida.
Para tareas más complejas podemos utilizar xargs -P, GNU Parallel o mecanismos de control más avanzados.
¿Cuándo lo utilizo?
Cuando tengo varias tareas independientes y quiero reducir el tiempo total de ejecución sin lanzar una cantidad ilimitada de procesos.
14. Crear archivos temporales y limpiarlos automáticamente
Muchas veces un script necesita crear archivos temporales.
Lo que no conviene es utilizar siempre el mismo nombre, como /tmp/datos.tmp.
Podemos generar nombres únicos con mktemp:
#!/usr/bin/env bash
set -euo pipefail

TEMP=$(mktemp)

trap 'rm -f -- "$TEMP"' EXIT

echo "Generando información temporal..." > "$TEMP"

cat "$TEMP"
Aquí aparece una de las funciones más interesantes de Bash:
trap 'rm -f -- "$TEMP"' EXIT
trap permite ejecutar instrucciones cuando se produce un evento determinado.
En este caso, cuando termina el shell que ejecuta el script, se elimina el archivo temporal.
Crear un directorio temporal
#!/usr/bin/env bash
set -euo pipefail

TEMP_DIR=$(mktemp -d)

trap 'rm -rf -- "$TEMP_DIR"' EXIT

echo "Directorio temporal: $TEMP_DIR"

touch "$TEMP_DIR/prueba.txt"
La ruta generada por mktemp -d es privada y única bajo las condiciones normales de funcionamiento.
Al terminar el script se limpia automáticamente.
Eso sí, trap EXIT no puede ejecutarse si el proceso recibe SIGKILL o termina abruptamente sin posibilidad de ejecutar su código de salida.
¿Cuándo lo utilizo?
En scripts que generan informes intermedios, descargan archivos temporales o necesitan un espacio de trabajo que no queremos conservar.
15. Crear un pequeño menú interactivo en Bash
Para finalizar, vamos con algo distinto.
No todos los scripts necesitan ejecutarse mediante argumentos. A veces puede resultar cómodo disponer de un menú.
Bash incorpora select, una construcción que nos permite crear menús sencillos:
#!/usr/bin/env bash

PS3="Selecciona una opción: "

opciones=(
    "Mostrar uso de disco"
    "Mostrar memoria"
    "Mostrar uptime"
    "Mostrar interfaces"
    "Salir"
)

select opcion in "${opciones[@]}"; do

    case "$REPLY" in

        1)
            df -h
            ;;

        2)
            free -h
            ;;

        3)
            uptime -p
            ;;

        4)
            ip -br addr
            ;;

        5)
            echo "Saliendo..."
            break
            ;;

        *)
            echo "Opción no válida"
            ;;

    esac

done
Al ejecutarlo veremos un menú parecido a este:
1) Mostrar uso de disco
2) Mostrar memoria
3) Mostrar uptime
4) Mostrar interfaces
5) Salir

Selecciona una opción:
La variable especial REPLY contiene la respuesta introducida.
La estructura case permite seleccionar qué operación ejecutar.
Es una forma sencilla de agrupar pequeñas herramientas sin tener que recordar todos los comandos.
¿Cuándo lo utilizo?
Para crear menús de diagnóstico, herramientas internas de soporte y pequeños asistentes para tareas administrativas.
Bonus: cinco trucos de Bash que merece la pena conocer
Después de los quince ejemplos, quiero añadir algunas expresiones que aparecen constantemente en los scripts y que conviene comprender.
1. Comprobar si una variable está vacía
[[ -z "$VARIABLE" ]] && echo "Variable vacía"
La condición -z comprueba si la longitud de la cadena es cero.
2. Asignar un valor predeterminado
PUERTO=${PUERTO:-22}
Si PUERTO no existe o está vacío, utilizamos 22 como valor.
Esto es muy útil para parámetros opcionales.
3. Obtener únicamente el nombre de un archivo
archivo="/home/usuario/documentos/informe.pdf"

echo "${archivo##*/}"
Resultado:
informe.pdf
La expresión ##*/ elimina desde el principio la coincidencia más larga que termina en /.
4. Extraer una extensión
archivo="informe.pdf"

echo "${archivo##*.}"
Resultado:
pdf
Este ejemplo presupone un nombre que contiene un punto. Si no lo contiene, devuelve el nombre completo.
5. Comprobar si existe un comando
if command -v docker >/dev/null 2>&1; then
    echo "Docker está instalado"
else
    echo "Docker no está disponible en PATH"
fi
La instrucción command -v nos permite comprobar si un comando está disponible para el shell.
Es muy útil al crear scripts que dependen de herramientas externas.
Buenas prácticas antes de automatizar
Cuando empezamos a escribir scripts, resulta tentador ejecutarlos directamente sobre directorios importantes o servidores de producción.
Yo prefiero seguir unas pautas sencillas.
Primero pruebo las operaciones con archivos temporales o datos de laboratorio.
Si el script va a borrar o renombrar archivos, comienzo mostrando las operaciones con echo o printf, sin ejecutarlas realmente.
Utilizo comillas alrededor de las variables que representan rutas y nombres de archivo, especialmente cuando pueden contener espacios.
Y cuando el script empieza a crecer, incorporo comprobaciones de errores, mensajes claros y códigos de salida adecuados.
También resulta útil pasar el script por ShellCheck, una herramienta que ayuda a detectar problemas frecuentes de programación en shell.
Un script pequeño no tiene por qué ser un script improvisado.
Para terminar
Lo interesante de Bash es que nos permite convertir tareas repetitivas en herramientas reutilizables sin necesidad de construir grandes programas.
Con un bucle podemos recorrer decenas de servidores. Con read podemos utilizar un archivo de texto como inventario. Con find procesamos directorios completos. Y combinando trap, mktemp o flock podemos preparar scripts más seguros y fáciles de mantener.
Muchos de estos ejemplos se pueden ampliar bastante, pero he preferido mantenerlos pequeños para que se entienda qué hace cada instrucción y resulte sencillo adaptarlos.
Al final, lo que busco con esta serie es precisamente eso: descubrir posibilidades de la consola que tenemos delante todos los días y que quizá todavía no estamos aprovechando.