Comandos cotidianos, opciones poco conocidas y trucos que pueden cambiar tu manera de trabajar en la terminal.
Llevo años trabajando con Linux y hay algo que todavía me sorprende: puedes utilizar un comando cientos de veces y descubrir, casi por casualidad, una opción que te habría ahorrado muchísimo trabajo.
Todos conocemos mkdir, cp, ls, grep o find. Son comandos que utilizamos casi sin pensar. Pero ¿cuántas veces hemos consultado realmente todas sus opciones?
Por ejemplo, sabemos que mkdir sirve para crear directorios. Lo que quizá no todo el mundo sabe es que, combinándolo con una característica del shell, podemos construir toda una estructura de carpetas, con varios niveles de profundidad, ejecutando una única línea.
Y esto es solo el principio.
En esta primera entrega vamos a explorar 15 comandos habituales de Linux, prestando atención a esas opciones que no solemos utilizar y que resultan especialmente útiles cuando administramos sistemas, desarrollamos aplicaciones o simplemente queremos trabajar mejor desde la terminal.
No hace falta instalar herramientas especiales. La mayoría de los ejemplos funcionan con utilidades GNU habituales en distribuciones como Debian, Ubuntu, Fedora o Manjaro. Algunos emplean características de Bash y Zsh.
1. mkdir: crear toda una estructura de directorios en una línea
Empecemos por un clásico.
La mayoría utilizamos mkdir así:
mkdir proyecto
Pero imaginemos que vamos a preparar una aplicación Python y necesitamos crear esta estructura:
proyecto/
├── src/
├── config/
├── docs/
├── tests/
└── logs/
Podríamos crear los directorios individualmente, pero existe una forma mucho más cómoda:
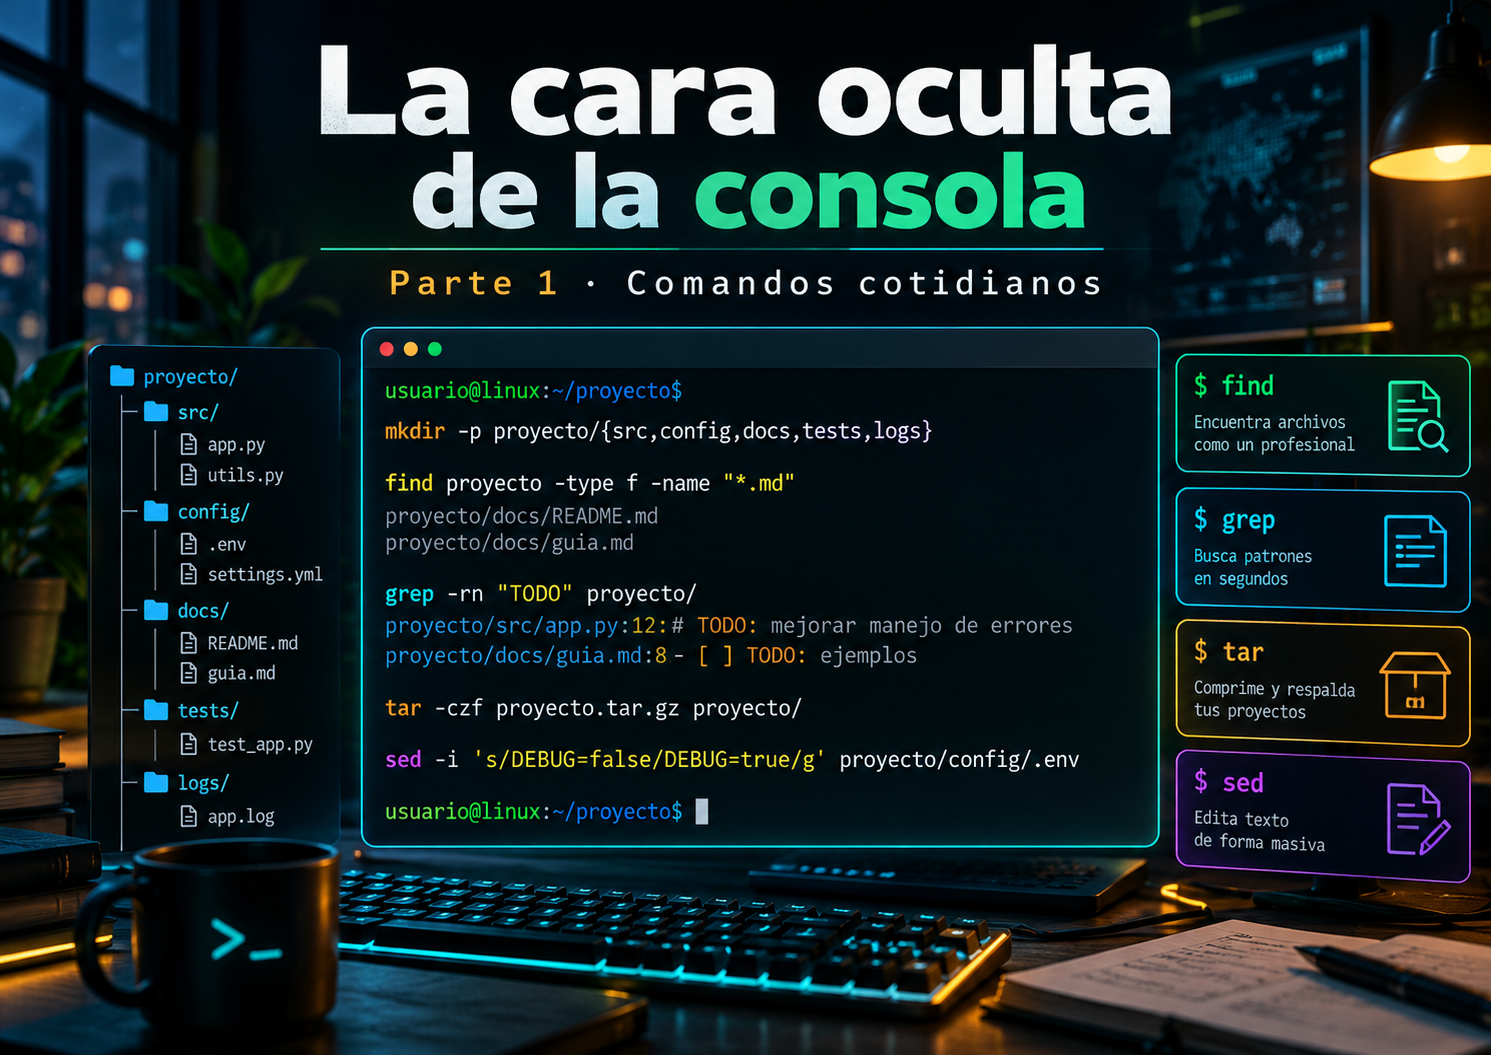
mkdir -p proyecto/{src,config,docs,tests,logs}
Con una sola instrucción hemos creado los cinco directorios.
¿Qué está sucediendo?
Aquí intervienen dos mecanismos diferentes:
-p(--parents) permite crear los directorios padre que falten y evita generar un error cuando un directorio ya existe.{...}es una expansión de llaves (brace expansion) que interpreta el shell antes de ejecutarmkdir.
Esto último es interesante: las llaves no son una opción de mkdir.
Podemos comprobar qué genera el shell:
echo proyecto/{src,config,docs,tests,logs}
Vamos un poco más lejos.
Supongamos que queremos crear la estructura de directorios para varios departamentos de una empresa:
mkdir -p empresa/{rrhh,ventas,it,marketing}/{2025,2026}
El resultado será:
empresa/
├── rrhh/
│   ├── 2025/
│   └── 2026/
├── ventas/
│   ├── 2025/
│   └── 2026/
├── it/
│   ├── 2025/
│   └── 2026/
└── marketing/
    ├── 2025/
    └── 2026/
También podemos crear jerarquías más complejas:
mkdir -p laboratorio/{redes/{cisco,nokia,mikrotik},linux/{debian,rocky,alpine},scripts/{python,bash}}
Y directorios numerados automáticamente:
mkdir -p router{01..10}
Esto crea diez directorios, desde router01 hasta router10.
Otra opción interesante: -m
Podemos establecer los permisos durante la creación:
mkdir -m 700 privado
En este caso, el propietario tendrá permisos de lectura, escritura y ejecución, mientras que los demás usuarios no tendrán acceso.
Conviene recordar que, si combinamos -m con -p, los permisos indicados no se aplican automáticamente a todos los directorios padre que se creen.
¿Cuándo lo utilizo?
Para preparar laboratorios, proyectos de desarrollo, estructuras de backups y scripts de despliegue. Es uno de esos pequeños trucos que terminan convirtiéndose en una costumbre.
2. cp: copiar archivos es solo el principio
Todos conocemos:
cp archivo.txt copia.txt
Pero cp permite operaciones bastante más interesantes.
Copiar conservando los atributos
cp -a origen/. destino/
La opción -a (archive) copia recursivamente e intenta conservar permisos, propietarios, fechas, enlaces simbólicos y otros atributos compatibles con el sistema de archivos y nuestros privilegios.
Es útil cuando necesitamos copiar configuraciones o directorios manteniendo sus características.
Conservar la estructura de directorios
Esta opción es una de mis favoritas:
cp --parents etc/nginx/nginx.conf backup/
Ejecutándola desde un directorio de trabajo que contenga la ruta relativa indicada, obtendremos:
backup/
└── etc/
    └── nginx/
        └── nginx.conf
--parents reproduce la ruta de origen dentro del destino.
Copiar sin sobrescribir
cp -n configuracion.conf backup/
La opción -n evita sobrescribir el archivo cuando ya existe en el destino.
Y si queremos crear copias de seguridad al sobrescribir:
cp --backup=numbered configuracion.conf destino/
GNU cp puede conservar versiones numeradas de archivos anteriores.
¿Cuándo lo utilizo?
Especialmente cuando modifico configuraciones de servicios y quiero conservar una copia anterior sin perder la organización original.
3. ls: ordenar, filtrar y descubrir información
Probablemente ls sea uno de los comandos más utilizados de Linux.
Estamos acostumbrados a ejecutar:
ls -lah
Sin embargo, hay opciones que permiten obtener información mucho más útil.
Ordenar por tamaño
ls -lahS
La -S ordena por tamaño, mostrando primero los archivos más grandes.
Ordenar por fecha
ls -lat
Muestra primero los archivos modificados más recientemente.
Si añadimos -r:
ls -latr
Invertimos el orden.
Mostrar inodos
ls -li
Esta opción muestra el número de inodo de cada archivo.
¿Por qué puede interesarnos?
Porque dos nombres de archivo diferentes pueden referirse al mismo inodo si son enlaces duros.
Podemos comprobarlo:
echo "Prueba" > original.txt
ln original.txt enlace.txt
ls -li original.txt enlace.txt
Veremos que ambos archivos comparten el mismo número de inodo.
Mostrar únicamente directorios
ls -d */
Aquí el patrón */ lo expande el shell. Es una forma sencilla de mostrar los directorios no ocultos del directorio actual, sin entrar en su contenido.
¿Cuándo lo utilizo?
Para revisar directorios de logs, examinar archivos recientes y comprobar enlaces duros.
4. find: buscar archivos con auténtica precisión
find es una herramienta que merece un artículo completo.
Su utilidad va mucho más allá de buscar archivos por nombre.
Archivos modificados recientemente
find /var/log -type f -mmin -30
Busca archivos cuyo contenido se ha modificado hace menos de 30 minutos.
Podemos utilizar horas aproximadas mediante minutos:
find /var/log -type f -mmin -120
Archivos grandes
find /home -type f -size +500M
Busca archivos mayores de 500 MiB, usando unidades de tamaño de GNU find.
Archivos vacíos
find . -type f -empty
Encuentra archivos sin contenido.
Archivos con permisos sospechosos
find . -type f -perm /002
Busca archivos que tienen activado el permiso de escritura para otros usuarios.
Puede servir como primer paso para revisar permisos demasiado abiertos.
Ejecutar un comando sobre los resultados
find . -type f -name "*.log" -exec ls -lh {} +
En lugar de mostrar simplemente los nombres, ejecutamos ls -lh sobre los archivos encontrados.
Aquí:
{}representa los archivos encontrados.+permite agrupar varios archivos en una misma ejecución del comando.
También podemos utilizar \; para ejecutar un comando individual por cada archivo.
¿Cuándo lo utilizo?
Cuando investigo archivos antiguos, problemas de espacio, permisos incorrectos o cambios recientes en un servidor.
5. du: descubrir dónde desaparece el espacio
Todos hemos vivido esta situación: el disco empieza a llenarse y necesitamos averiguar qué directorio está consumiendo el espacio.
Podemos empezar con:
du -h --max-depth=1 /var
La opción --max-depth=1 limita el desglose a un nivel de profundidad.
Si buscamos una visión más compacta:
du -sh /var/*
Pero una combinación especialmente útil es:
du -ah /var/log | sort -h | tail -20
Esto permite localizar los elementos que más espacio ocupan dentro de /var/log.
Cada comando aporta algo:
du -ahmuestra tamaños de archivos y directorios.sort -hordena valores que incluyen unidades legibles.tail -20muestra las últimas veinte líneas del resultado ordenado.
Para buscar exclusivamente los directorios más grandes:
du -h --max-depth=1 /var | sort -hr
¿Cuándo lo utilizo?
Para investigar discos llenos, directorios de logs, backups y volúmenes de aplicaciones.
6. df: cuando queda espacio, pero Linux dice que no
Normalmente consultamos el espacio disponible con:
df -h
Pero Linux puede mostrar un error parecido a:
No space left on device
aunque aparentemente todavía existan gigabytes libres.
¿Cómo es posible?
Una causa puede ser el agotamiento de inodos.
Para comprobarlo:
df -ih
Los inodos permiten al sistema de archivos mantener información sobre los archivos y directorios.
En sistemas de archivos que tienen un número limitado de inodos, como sucede habitualmente con ext4, podemos agotarlos aunque quede espacio disponible para los datos.
Esto suele ocurrir cuando se generan cantidades enormes de archivos pequeños.
Otra opción útil
df -hT
La -T muestra también el tipo de sistema de archivos.
¿Cuándo lo utilizo?
Cuando investigo errores de almacenamiento, especialmente si los valores de espacio libre parecen contradecir los errores que devuelve una aplicación.
7. grep: encontrar información sin leer miles de líneas
Buscar una palabra dentro de un archivo es sencillo:
grep "ERROR" aplicacion.log
Pero grep puede ayudarnos a interpretar mucho mejor los resultados.
Mostrar contexto
grep -C 3 "ERROR" aplicacion.log
Con -C 3, además de la coincidencia, veremos tres líneas anteriores y tres posteriores.
También podemos utilizar:
grep -B 5 "ERROR" aplicacion.log
grep -A 5 "ERROR" aplicacion.log
-B muestra las líneas anteriores y -A las posteriores.
Ignorar comentarios y líneas vacías
grep -vE '^[[:space:]]*(#|$)' configuracion.conf
Esta expresión filtra líneas vacías y aquellas cuyo primer carácter no blanco es #.
Resulta muy útil cuando examinamos archivos de configuración que contienen cientos de comentarios.
Buscar recursivamente
grep -Rni "database" ./config/
Busca dentro de los archivos del directorio indicado y muestra el nombre del archivo y el número de línea de cada coincidencia.
¿Cuándo lo utilizo?
Para examinar logs, comparar configuraciones y localizar rápidamente parámetros que necesito revisar.
8. sort: ordenar datos y detectar duplicados
sort parece un comando muy básico, pero combinado con otros resulta extremadamente útil.
Ordenar y eliminar duplicados
sort -u usuarios.txt
La opción -u elimina las líneas duplicadas del resultado ordenado.
Ordenación numérica
sort -n numeros.txt
Sin -n, los números se ordenan como texto, lo que puede producir resultados inesperados.
Ordenar por columnas
sort -t: -k3,3n /etc/passwd
En este ejemplo:
-t:establece:como separador.-k3,3selecciona la tercera columna.nsolicita ordenación numérica.
Con ello ordenamos las entradas de /etc/passwd según el UID.
¿Cuándo lo utilizo?
Para procesar inventarios, resultados de comandos, listados de usuarios y archivos de datos sencillos.
9. cut: extraer exactamente lo que necesitamos
Muchas herramientas producen información organizada en columnas.
cut permite extraer campos sin necesidad de abrir un editor o escribir un programa.
Por ejemplo:
cut -d: -f1 /etc/passwd
Obtendremos los nombres de usuario registrados en el archivo.
La opción -d: indica el delimitador y -f1 selecciona el primer campo.
Podemos extraer varios campos:
cut -d: -f1,7 /etc/passwd
Esto muestra el nombre de usuario y la shell configurada.
También podemos trabajar con posiciones de caracteres:
cut -c1-10 archivo.txt
Extrae las primeras diez posiciones de caracteres de cada línea.
Una limitación: cut -d, sirve para archivos de texto delimitados sencillos, pero no interpreta correctamente todas las reglas de CSV, como los campos entrecomillados que contienen comas.
¿Cuándo lo utilizo?
Para extraer columnas de salidas de comandos, archivos de inventario y formatos de texto delimitados.
10. tee: guardar información mientras la vemos
Supongamos que estamos ejecutando un diagnóstico y queremos guardar el resultado sin dejar de verlo en la terminal.
Podemos utilizar:
ls -lah /var/log | tee listado.txt
tee recibe la salida del comando y la envía simultáneamente a la pantalla y al archivo.
Añadir contenido sin sobrescribir
date | tee -a actividad.log
La opción -a añade el contenido al final del archivo.
Escribir archivos protegidos
Esta combinación es especialmente interesante:
echo "DEBUG=false" | sudo tee /etc/miapp.conf
En una redirección tradicional:
sudo echo "DEBUG=false" > /etc/miapp.conf
el sudo se aplica a echo, pero la redirección la realiza nuestro shell con los permisos del usuario actual.
Por eso puede fallar.
Con sudo tee, el proceso que escribe en el archivo sí dispone de los privilegios correspondientes.
Hay que tener cuidado: sin -a, tee sobrescribe el archivo de destino.
¿Cuándo lo utilizo?
Para registrar diagnósticos, guardar resultados de pruebas y escribir configuraciones desde scripts.
11. xargs: convertir una lista en operaciones
xargs recibe elementos desde la entrada estándar y los convierte en argumentos para ejecutar otro comando.
Por ejemplo:
printf '%s\n' archivo1.txt archivo2.txt | xargs wc -l
Cuenta las líneas de los archivos indicados.
Pero lo interesante aparece al combinarlo con find.
find . -type f -name "*.log" -print0 | xargs -0 -r gzip
Este ejemplo busca archivos .log y los comprime con gzip.
¿Por qué utilizamos -print0 y -0?
Porque los nombres de archivo pueden contener espacios, tabulaciones e incluso saltos de línea.
-print0 separa las rutas mediante caracteres nulos y xargs -0 interpreta correctamente esa separación.
La opción -r, disponible en GNU xargs, evita ejecutar el comando cuando no hay argumentos.
Conviene probar primero una operación que no modifique archivos, especialmente cuando estamos creando una combinación nueva de find y xargs.
¿Cuándo lo utilizo?
En tareas de mantenimiento y procesamiento de muchos archivos, especialmente cuando quiero evitar escribir un bucle manual.
12. tar: trabajar con archivos comprimidos sin extraerlos
tar es habitual en backups y distribución de archivos.
Todos conocemos:
tar -czf backup.tar.gz proyecto/
Pero no siempre necesitamos extraer un archivo completo para consultar su contenido.
Listar el contenido
tar -tf backup.tar.gz
Permite examinar los nombres de los elementos almacenados.
Extraer en otra ubicación
mkdir -p /tmp/restauracion

tar -xzf backup.tar.gz -C /tmp/restauracion
La opción -C indica el directorio de destino.
Leer un archivo directamente
tar -xOf backup.tar.gz proyecto/config/app.conf
La opción -O envía el contenido extraído a la salida estándar.
Podemos combinarlo con grep:
tar -xOf backup.tar.gz proyecto/config/app.conf | grep "DEBUG"
De esta manera inspeccionamos una configuración almacenada dentro de un backup sin extraerla al sistema de archivos.
El nombre del elemento debe coincidir con la ruta almacenada en el archivo, que podemos consultar previamente con tar -tf.
¿Cuándo lo utilizo?
Cuando reviso backups, comparo configuraciones antiguas o necesito recuperar un archivo concreto.
13. sed: pequeñas modificaciones sin abrir un editor
sed es un editor de flujos de texto.
Aunque parece complejo al principio, algunas de sus opciones son muy sencillas y nos ahorran bastante trabajo.
Mostrar un rango de líneas
sed -n '10,20p' archivo.conf
La opción -n desactiva la impresión automática y 10,20p solicita mostrar las líneas 10 a 20.
Eliminar comentarios de la salida
sed '/^[[:space:]]*#/d; /^[[:space:]]*$/d' archivo.conf
Esto permite visualizar una configuración sin comentarios ni líneas vacías.
Sustituir texto
sed 's/DEBUG=true/DEBUG=false/' app.conf
Muestra el contenido con las sustituciones, pero no modifica el archivo original.
Si queremos guardar los cambios:
sed -i.bak 's/DEBUG=true/DEBUG=false/' app.conf
La opción -i.bak edita el archivo y crea una copia con extensión .bak.
Hay un detalle importante: la expresión sustituye la primera coincidencia de cada línea. Para reemplazar todas las coincidencias de una línea, podemos añadir g al final de la expresión.
¿Cuándo lo utilizo?
Para automatizar pequeños cambios en configuraciones, preparar scripts y transformar archivos de texto.
14. stat: conocer la información real de un archivo
ls -l muestra información útil, pero stat puede enseñarnos bastante más.
stat archivo.txt
Podemos consultar tamaño, permisos, inodo y distintas marcas temporales.
Personalizar la salida
stat -c '%n | %s bytes | %a | %U:%G' archivo.txt
Aquí seleccionamos:
%n: nombre.%s: tamaño en bytes.%a: permisos en formato octal.%U: propietario.%G: grupo.
Examinar modificaciones
stat -c '%n | mtime: %y | ctime: %z' archivo.txt
Este ejemplo muestra dos marcas de tiempo diferentes:
- mtime: indica cuándo se modificó por última vez el contenido del archivo.
- ctime: indica cuándo cambió por última vez el estado de su inodo, por ejemplo, tras modificar permisos, propietario o contenido.
Un detalle que conviene conocer: ctime no significa creation time. No representa la fecha de creación.
Podemos comprobarlo en un archivo de prueba:
touch prueba.txt
stat -c '%y | %z' prueba.txt

sleep 2
chmod 600 prueba.txt

stat -c '%y | %z' prueba.txt
Después del chmod, normalmente veremos que ctime ha cambiado mientras mtime permanece igual.
¿Cuándo lo utilizo?
Al investigar cambios de permisos, modificaciones inesperadas y problemas relacionados con archivos.
15. install: el comando que puede sustituir a mkdir, cp y chmod
He dejado este comando para el final porque creo que es uno de los menos aprovechados.
Aunque se llame install, no sirve únicamente para instalar programas.
También es útil para copiar archivos, preparar directorios y establecer permisos durante despliegues.
Imaginemos que necesitamos crear esta estructura:
/opt/miapp/
├── config/
├── logs/
└── data/
Podemos ejecutar:
install -d -m 750 /opt/miapp/{config,logs,data}
La opción -d crea directorios y -m 750 establece los permisos en los directorios especificados.
Si los directorios padre no existen, también pueden crearse, aunque no necesariamente con el mismo modo.
Copiar y establecer permisos
install -m 640 app.conf /opt/miapp/config/app.conf
Copia el archivo y establece sus permisos.
Crear la ruta necesaria automáticamente
install -D -m 640 app.conf /opt/miapp/config/app.conf
Con -D, GNU install puede crear los directorios padre que falten antes de instalar el archivo.
Esto simplifica bastante algunos scripts de despliegue.
También permite establecer propietario y grupo mediante las opciones -o y -g, siempre que tengamos los privilegios necesarios.
¿Cuándo lo utilizo?
En scripts de instalación, despliegues de aplicaciones y preparación de configuraciones en servidores Linux.
Es una herramienta especialmente interesante cuando queremos hacer más claras y compactas nuestras automatizaciones.
Bonus: cuatro trucos que no pertenecen realmente a los comandos
Antes de terminar, quiero añadir algo que suele provocar confusión.
Hay operaciones que parecen funciones de un comando, pero en realidad son características del shell.
Bash y Zsh tienen mecanismos propios para expandir expresiones, manipular rutas y ejecutar instrucciones.
Crear una copia con expansión de llaves
cp nginx.conf{,.bak}
El shell transforma esa expresión en dos argumentos:
cp nginx.conf nginx.conf.bak
Es una manera cómoda de crear una copia de seguridad antes de editar una configuración.
Crear directorios numerados
mkdir -p router{01..10}
Como hemos visto al principio, la expansión genera automáticamente los diez nombres.
Ejecutar comandos en otro directorio sin cambiar el actual
(cd /var/log && ls -lah)
Los paréntesis ejecutan las instrucciones en una subshell. Cuando finaliza, seguimos en el directorio desde el que lanzamos el comando. Esto es especialmente útil en scripts.
Comparar resultados sin archivos temporales
diff <(sort lista1.txt) <(sort lista2.txt)
Aquí utilizamos la sustitución de procesos (process substitution), disponible en Bash y Zsh.
Podemos comparar los resultados de dos comandos como si fueran archivos, sin crear copias temporales manualmente.
Un pequeño laboratorio para practicar
Podemos probar varias de las técnicas anteriores sin tocar directorios críticos del sistema. Primero creamos una estructura temporal:
LAB=$(mktemp -d)
cd "$LAB" || exit 1

mkdir -p proyecto/{src,config,docs,tests,logs}
Generamos algunos archivos:
printf 'DEBUG=true\nPORT=8080\n' > proyecto/config/app.conf

printf 'INFO inicio\nERROR conexión\nINFO reintento\n' > proyecto/logs/app.log

touch proyecto/src/main.py
Ahora podemos probar varias operaciones.
Consultar la estructura:
find proyecto -print
Mostrar la configuración sin comentarios ni líneas vacías:
grep -vE '^[[:space:]]*(#|$)' proyecto/config/app.conf
Buscar errores mostrando contexto:
grep -C 2 "ERROR" proyecto/logs/app.log
Consultar metadatos:
stat -c '%n | %s bytes | %a' proyecto/config/app.conf
Crear un backup:
tar -czf backup.tar.gz proyecto/
Y leer la configuración directamente desde el backup:
tar -xOf backup.tar.gz proyecto/config/app.conf
Cuando hayamos terminado, podemos consultar el valor de la variable:
echo "$LAB"
Y, desde el mismo shell donde creamos el laboratorio, eliminarlo de forma controlada:
cd "$HOME" || exit 1
rm -ri -- "$LAB"
La opción -i solicita confirmación durante el borrado. Antes de aceptar, conviene comprobar que la ruta corresponde al laboratorio temporal.
Para terminar
Lo que más me gusta de Linux es que siempre quedan cosas por descubrir, incluso dentro de herramientas que utilizamos diariamente.
Muchas veces buscamos nuevos programas para resolver problemas que las herramientas tradicionales ya saben solucionar. Solo necesitamos conocer un poco mejor sus opciones.
En esta primera entrega hemos trabajado con archivos, directorios, búsquedas, texto y algunas funciones del shell.
En la segunda parte iremos un poco más lejos: procesos que mantienen archivos borrados, puertos abiertos, rutas de red, logs de systemd y herramientas que resultan especialmente útiles cuando algo falla en un servidor.
Porque una cosa es utilizar Linux y otra bastante distinta es descubrir todo lo que podemos hacer con sus herramientas.