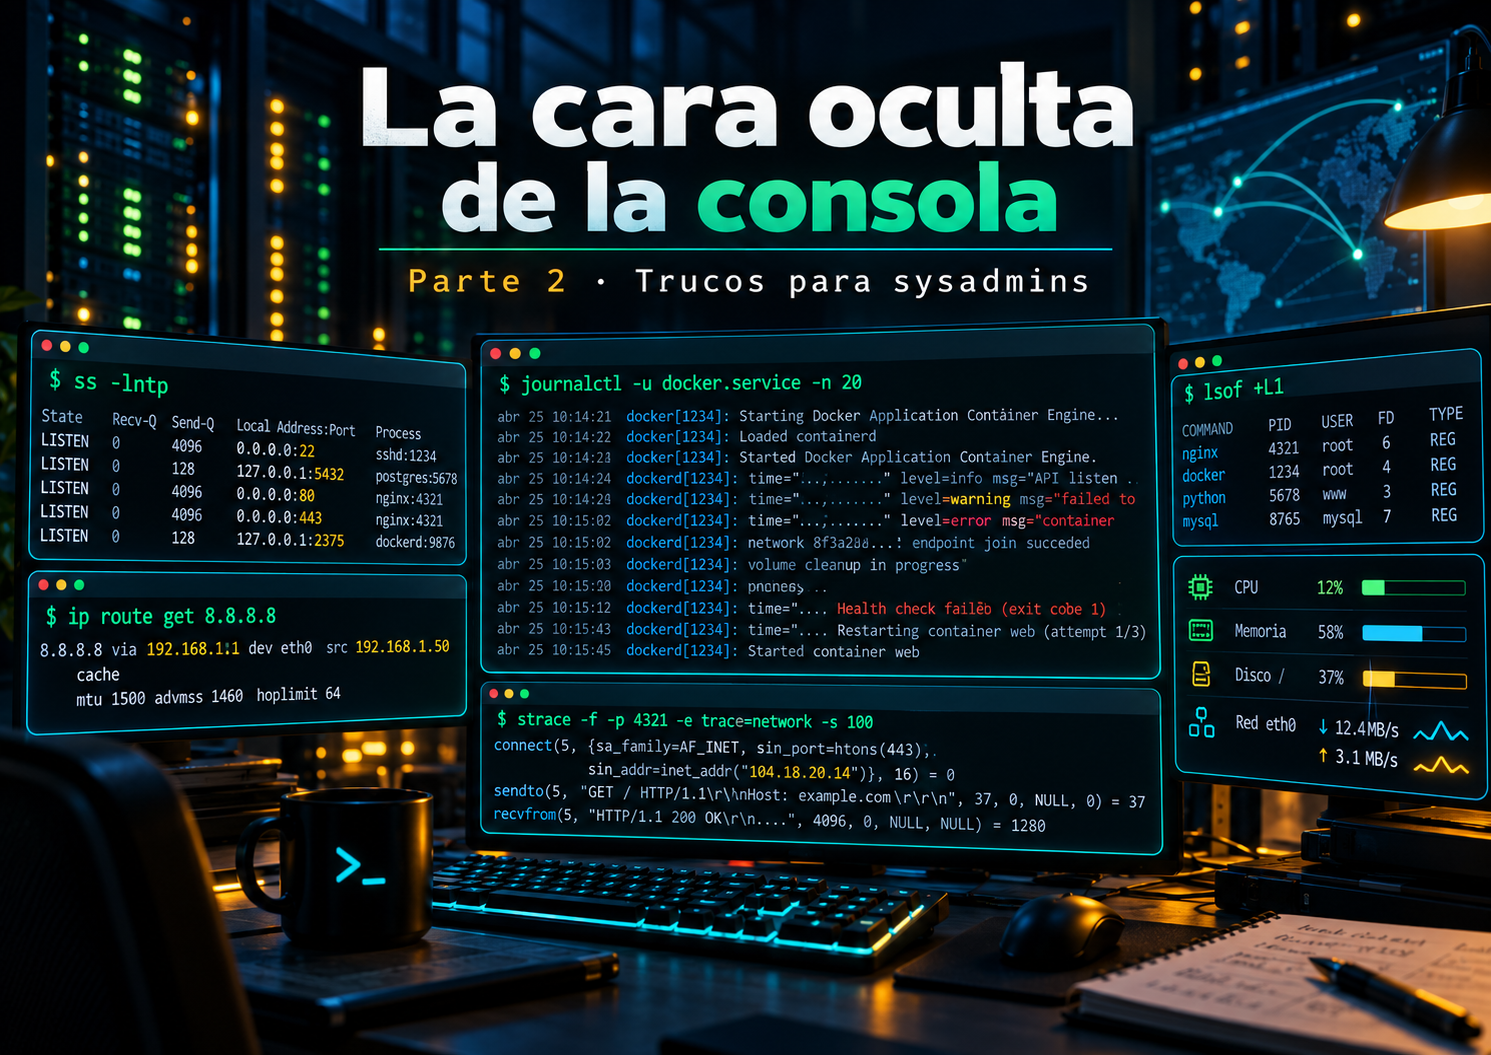
Procesos ocultos a simple vista, espacio en disco que no se libera, conexiones de red, permisos y herramientas de diagnóstico que pueden sacarnos de más de un apuro.
En la primera parte de esta serie descubrimos que comandos tan conocidos como mkdir, cp, grep o find esconden opciones que pueden facilitarnos bastante el trabajo.
Ahora vamos a cambiar un poco de escenario.
Imaginemos que estamos administrando un servidor Linux. Una aplicación deja de responder, el disco se está llenando, un servicio no consigue abrir un archivo o simplemente queremos averiguar qué proceso está utilizando determinado puerto.
Son situaciones que tarde o temprano aparecen cuando trabajamos en sistemas.
Lo curioso es que muchas veces tenemos la solución delante, en herramientas que ya vienen instaladas o que podemos incorporar fácilmente desde los repositorios de nuestra distribución.
En esta segunda entrega voy a repasar 15 comandos y algunas de sus opciones menos utilizadas. No se trata de memorizar parámetros, sino de comprender qué información podemos obtener y cuándo merece la pena utilizar cada herramienta.
Los ejemplos están pensados para distribuciones Linux actuales que utilizan systemd, como Debian, Fedora, Rocky Linux o Manjaro. Algunas utilidades, como lsof o fuser, pueden requerir instalación.
1. ps: descubrir qué está consumiendo los recursos
Cuando hablamos de procesos, probablemente uno de los primeros comandos que aprendemos es:
ps aux
Nos muestra una lista de procesos, pero podemos pedirle información mucho más específica.
Ordenar por consumo de memoria
ps -eo pid,ppid,user,stat,%mem,%cpu,cmd --sort=-%mem
Este comando permite identificar rápidamente los procesos que están consumiendo más memoria.
Vamos a descomponerlo:
-e: selecciona todos los procesos.-o: permite definir qué columnas queremos mostrar.pid: identificador del proceso.ppid: identificador de su proceso padre.stat: estado del proceso.%mem: porcentaje de memoria física utilizado.%cpu: utilización de CPU según las estadísticas deps.--sort=-%mem: ordena por memoria de mayor a menor.
Si solo queremos ver los diez primeros:
ps -eo pid,comm,%mem,%cpu --sort=-%mem | head -11
¿Por qué once líneas? Porque la primera corresponde a la cabecera.
Descubrir la jerarquía de procesos
ps -ef --forest
La opción --forest presenta las relaciones padre-hijo en forma de árbol.
Esto es especialmente útil cuando investigamos aplicaciones que crean varios procesos, como un servidor web o una aplicación Python ejecutada mediante Gunicorn.
¿Cuándo lo utilizo?
Cuando un servidor empieza a consumir demasiada memoria, quiero localizar procesos relacionados o necesito comprender qué aplicación ha iniciado determinado proceso.
2. pgrep: encontrar procesos sin depender de grep
Una combinación bastante habitual es:
ps aux | grep nginx
Funciona, pero también puede mostrar el propio proceso grep.
Para estas situaciones tenemos pgrep.
pgrep -af nginx
Sus opciones son:
-a: muestra la línea de comandos.-f: busca en la línea de comandos completa y no solamente en el nombre del proceso.
Buscar procesos de un usuario
pgrep -u root -a sshd
Muestra los procesos coincidentes que pertenecen a root.
Buscar el proceso más reciente
pgrep -n -f nginx
La opción -n selecciona el proceso coincidente más reciente.
También existe -o para seleccionar el más antiguo.
¿Cuándo lo utilizo?
Para localizar rápidamente procesos que forman parte de un servicio, especialmente cuando conozco su nombre pero desconozco el PID.
3. kill: comprobar procesos sin detenerlos
Todos conocemos kill como el comando que permite enviar señales a los procesos.
Por ejemplo:
kill -TERM 1234
Envía la señal SIGTERM al proceso indicado, solicitando su finalización.
Pero tiene una opción poco conocida:
kill -0 1234
¿Qué hace?
No envía una señal efectiva al proceso. Comprueba si el proceso existe y si tenemos permisos para enviarle señales.
Podemos aprovecharlo en scripts:
if kill -0 1234 2>/dev/null; then
    echo "El proceso existe y puedo enviarle señales"
else
    echo "El proceso no existe o no tengo permisos"
fi
Es importante entender la diferencia: un resultado negativo no demuestra necesariamente que el proceso haya terminado. También puede significar que no tenemos permisos.
Y un resultado positivo tampoco garantiza que el proceso esté funcionando correctamente.
Consultar las señales disponibles
kill -l
Permite ver las señales que admite el sistema.
¿Cuándo lo utilizo?
En scripts de supervisión sencillos y cuando necesito comprobar la presencia de un proceso sin modificar su estado.
4. ss: descubrir quién está escuchando en un puerto
Uno de los problemas más habituales cuando administramos servidores es encontrar un puerto ocupado.
Imaginemos que intentamos arrancar una aplicación Flask en el puerto 8000 y recibimos un error indicando que la dirección ya está en uso.
Podemos investigar con:
sudo ss -lntp
Cada opción tiene una función:
-l: muestra sockets en escucha.-n: evita resolver nombres de servicios y direcciones.-t: selecciona sockets TCP.-p: muestra información de los procesos asociados, cuando está disponible.
Si queremos consultar un puerto concreto:
sudo ss -lntp 'sport = :8000'
De esta manera podemos identificar qué proceso mantiene abierto el puerto 8000.
Consultar conexiones establecidas
ss -tn state established
Muestra conexiones TCP establecidas.
Ver estadísticas generales
ss -s
Ofrece un resumen de los sockets.
¿Cuándo lo utilizo?
Al diagnosticar conflictos de puertos, comprobar servicios web o revisar conexiones de red.
5. ip: saber exactamente por dónde saldrá un paquete
Este es uno de los comandos que más utilizo cuando trabajo con redes.
Todos conocemos:
ip addr
ip route
Pero hay una opción especialmente interesante.
ip route get 8.8.8.8
Con ella podemos consultar qué ruta seleccionaría el kernel para llegar a esa dirección.
Una salida podría ser:
8.8.8.8 via 192.168.1.1 dev enp3s0 src 192.168.1.100 uid 1000
La información importante es:
via: siguiente salto.dev: interfaz de salida.src: dirección IP de origen seleccionada.uid: identificador de usuario asociado a la consulta, cuando aparece.
No estamos enviando un paquete ICMP ni comprobando que el destino responda.
Estamos consultando la decisión de encaminamiento del kernel.
Consultar la ruta con una IP de origen
ip route get 8.8.8.8 from 192.168.1.100
Esto puede resultar útil en servidores con múltiples direcciones IP o reglas de encaminamiento.
Ver interfaces de manera compacta
ip -br addr
La opción -br muestra una salida resumida, muy cómoda cuando el equipo tiene muchas interfaces.
¿Cuándo lo utilizo?
En servidores con varias tarjetas de red, VPN, rutas estáticas, interfaces virtuales y laboratorios con Docker o Containerlab.
6. journalctl: encontrar errores sin leer miles de mensajes
En distribuciones con systemd, journalctl permite consultar los registros del sistema.
Podemos comenzar con:
journalctl -b
La opción -b muestra los mensajes correspondientes al arranque actual.
Pero podemos afinar mucho más.
Mostrar únicamente errores
journalctl -p err -b
La opción -p err filtra los mensajes por prioridad, incluyendo los niveles de error y los más graves.
Consultar los últimos treinta minutos
journalctl --since "30 minutes ago"
Investigar un servicio concreto
Por ejemplo, para examinar los logs de Docker:
sudo journalctl -u docker.service --since "1 hour ago"
Seguir los logs en tiempo real
journalctl -u docker.service -f
La opción -f funciona de manera parecida a tail -f.
Ver mensajes del arranque anterior
journalctl -b -1
Esta opción resulta especialmente útil después de un reinicio inesperado.
Hay que recordar que depende de que se conserven los registros del arranque anterior.
¿Cuándo lo utilizo?
Para investigar servicios que no arrancan, errores después de una actualización, problemas de hardware y fallos que se produjeron antes de reiniciar el servidor.
7. systemctl: descubrir tareas que se ejecutan solas
systemctl suele asociarse a operaciones como:
sudo systemctl restart nginx
systemctl status nginx
Pero systemd hace bastante más que iniciar y detener servicios.
También dispone de temporizadores que permiten programar tareas.
Consultar todos los temporizadores
systemctl list-timers --all
Podemos ver qué temporizadores existen, cuándo se ejecutaron por última vez y cuándo está prevista su siguiente activación.
Esto es útil para descubrir tareas automáticas como actualizaciones, limpieza de archivos temporales o renovaciones de certificados, siempre que estén configuradas mediante temporizadores de systemd.
Ver los servicios que han fallado
systemctl --failed
Nos muestra las unidades que están en estado fallido.
Consultar las dependencias de un servicio
systemctl list-dependencies docker.service
Permite visualizar las unidades relacionadas mediante dependencias.
¿Cuándo lo utilizo?
Para revisar tareas periódicas, investigar servicios fallidos y comprender las relaciones entre unidades de systemd.
8. lsof: el archivo está borrado, pero sigue ocupando espacio
Este comando merece especial atención.
Imaginemos la siguiente situación:
Un servidor tiene el disco casi lleno. Investigamos y encontramos un archivo de log que ocupa varios gigabytes.
Decidimos eliminarlo.
Después ejecutamos:
df -h
Y descubrimos que prácticamente no se ha liberado espacio.
¿Qué está pasando?
En Linux, un archivo puede haber sido eliminado de su directorio y continuar existiendo mientras algún proceso lo mantenga abierto.
Para localizar estos casos:
sudo lsof +L1
La opción +L1 selecciona archivos abiertos cuyo contador de enlaces es inferior a uno; es decir, archivos desvinculados que todavía están abiertos.
Podemos encontrar el PID del proceso, el descriptor y el archivo implicado.
Buscar qué proceso utiliza un archivo
sudo lsof /var/log/miapp.log
Examinar archivos abiertos por un proceso
sudo lsof -p 1234
Identificar qué utiliza un puerto
sudo lsof -nP -iTCP:8000 -sTCP:LISTEN
Aquí -nP evita resolver nombres de hosts y puertos.
¿Cuándo lo utilizo?
Cuando el espacio en disco no se libera tras borrar archivos, un proceso mantiene recursos abiertos o necesito saber quién está utilizando determinado puerto.
Una precaución: no conviene reiniciar procesos ni manipular descriptores abiertos a ciegas. Primero hay que identificar el servicio y evaluar las consecuencias.
9. fuser: averiguar qué proceso está utilizando un recurso
En ocasiones intentamos desmontar un sistema de archivos y recibimos:
target is busy
Esto significa que algún proceso puede estar utilizando archivos, directorios u otros recursos relacionados con ese sistema de archivos.
Una herramienta muy útil para investigarlo es fuser.
sudo fuser -vm /mnt/datos
La opción -m selecciona procesos que utilizan el sistema de archivos al que pertenece la ruta indicada.
La opción -v muestra información detallada.
Investigar un puerto TCP
sudo fuser -v -n tcp 8000
Nos ayuda a identificar procesos relacionados con ese puerto.
Existe también la opción -k, que permite enviar señales a procesos seleccionados.
Pero en un servidor de producción conviene tratarla con mucho cuidado: puede afectar a procesos que estén utilizando el recurso y provocar una interrupción del servicio.
¿Cuándo lo utilizo?
Para investigar sistemas de archivos ocupados, dispositivos en uso y conflictos relacionados con puertos o recursos.
10. timeout: evitar comandos que nunca terminan
Seguro que alguna vez hemos ejecutado una operación que se ha quedado bloqueada mucho más tiempo del esperado.
En automatización esto puede convertirse en un problema serio.
Para limitar el tiempo de ejecución tenemos timeout.
timeout 5s ping 8.8.8.8
Permite ejecutar ping durante un máximo aproximado de cinco segundos.
Cuando se alcanza el límite, timeout intenta finalizar el comando enviándole una señal.
Limitar el tiempo de un script
timeout 60s ./diagnostico.sh
Enviar otra señal
timeout -s INT 10s ./proceso.sh
La opción -s permite especificar la señal.
Establecer un límite adicional
timeout -k 5s 30s ./proceso.sh
Primero intenta terminar el proceso cuando alcanza los 30 segundos.
Si continúa ejecutándose cinco segundos después, envía SIGKILL.
SIGKILL impide realizar una finalización normal, por lo que debe reservarse para situaciones donde realmente lo necesitemos.
¿Cuándo lo utilizo?
En scripts de diagnóstico, tareas automatizadas y operaciones que podrían bloquear un proceso de mantenimiento.
11. watch: convertir cualquier comando en un monitor
Normalmente ejecutamos un comando, vemos el resultado y volvemos a lanzarlo cuando queremos comprobar si algo ha cambiado.
watch automatiza este proceso.
watch -n 2 'df -h'
Ejecuta df -h aproximadamente cada dos segundos.
Resaltar los cambios
watch -d -n 2 'free -h'
La opción -d resalta diferencias entre actualizaciones.
Esto resulta muy cómodo para detectar cambios de consumo de memoria.
Supervisar conexiones
watch -n 2 'ss -s'
Supervisar un servicio
watch -n 5 'systemctl is-active docker.service'
Podemos detener la supervisión con Ctrl+C.
¿Cuándo lo utilizo?
Para observar consumos, comprobar el estado de servicios o seguir una situación cambiante sin ejecutar manualmente el mismo comando una y otra vez.
12. flock: evitar que dos scripts se ejecuten simultáneamente
Imaginemos que tenemos un script de backup programado.
Normalmente tarda cinco minutos, pero un día, por cualquier motivo, necesita más tiempo.
Antes de terminar, se inicia una segunda ejecución.
Ahora tenemos dos procesos de backup trabajando al mismo tiempo, posiblemente utilizando los mismos archivos y destinos.
Para evitarlo podemos utilizar flock.
flock -n /tmp/backup.lock ./backup.sh
La opción -n solicita adquirir el bloqueo sin esperar.
Si otro proceso mantiene un bloqueo incompatible sobre el mismo archivo, el comando no ejecutará el script.
Esperar un tiempo limitado
flock -w 10 /tmp/backup.lock ./backup.sh
Aquí permitimos esperar hasta diez segundos para conseguir el bloqueo.
Utilizarlo dentro de un script
#!/usr/bin/env bash

exec 9>/tmp/backup.lock

flock -n 9 || {
    echo "Ya existe otra ejecución"
    exit 1
}

echo "Iniciando backup..."
sleep 10
echo "Backup finalizado"
El descriptor 9 mantiene abierto el archivo de bloqueo mientras lo utilice el script.
Una ventaja es que el bloqueo se libera automáticamente cuando se cierran los descriptores correspondientes, por ejemplo al finalizar el proceso.
Eso no implica que el archivo /tmp/backup.lock desaparezca: puede permanecer en el directorio sin representar un bloqueo activo.
¿Cuándo lo utilizo?
En backups, tareas programadas, sincronizaciones y procesos que no deben ejecutarse simultáneamente.
13. namei: descubrir dónde fallan realmente los permisos
Este comando es uno de los más interesantes de esta lista.
Imaginemos que Nginx intenta servir un archivo ubicado en:
/var/www/miweb/static/index.html
Comprobamos sus permisos:
ls -l /var/www/miweb/static/index.html
El archivo parece tener permisos correctos.
Sin embargo, el servidor devuelve un error de acceso.
¿Por qué?
Porque para acceder a un archivo necesitamos poder atravesar los directorios de su ruta.
Podemos comprobarlos con:
namei -l /var/www/miweb/static/index.html
namei descompone la ruta y muestra información sobre cada uno de sus componentes.
Esto nos permite comprobar los permisos de:
/
 /var
 /var/www
 /var/www/miweb
 /var/www/miweb/static
 /var/www/miweb/static/index.html
El permiso de ejecución sobre un directorio permite atravesarlo durante la resolución de la ruta, siempre que se cumplan también las demás condiciones de acceso.
Un archivo puede tener permisos de lectura para todos y seguir siendo inaccesible porque uno de sus directorios padre impide el acceso.
Mostrar propietarios y grupos
namei -l -o /var/www/miweb/static/index.html
La opción -o permite mostrar propietarios y grupos.
¿Cuándo lo utilizo?
En errores Permission denied, problemas con servidores web y accesos fallidos a archivos que aparentemente tienen permisos correctos.
Hay que recordar que los permisos tradicionales no son el único control posible: también pueden intervenir ACL y políticas de seguridad como SELinux.
14. free: comprender cómo utiliza Linux la memoria
Una situación bastante habitual es ejecutar:
free -h
y preocuparse al comprobar que el valor de memoria libre es muy bajo.
Pero Linux utiliza memoria disponible para cachés y otras optimizaciones.
Eso no significa necesariamente que el sistema esté quedándose sin memoria utilizable.
Mostrar información en formato legible
free -h
Entre sus columnas encontraremos:
total: memoria total.used: memoria utilizada según los cálculos de la herramienta.free: memoria completamente libre.buff/cache: memoria empleada en búferes y cachés.available: estimación de la memoria disponible para iniciar nuevas aplicaciones sin recurrir significativamente a swap.
Para una evaluación rápida de la memoria disponible, la columna available suele resultar más útil que observar únicamente free.
Supervisar la memoria periódicamente
free -h -s 2
La opción -s 2 actualiza la información cada dos segundos.
Consultar también totales
free -ht
Añade una fila de totales.
¿Cuándo lo utilizo?
Para comprobar consumos, estudiar problemas de memoria y evitar interpretar la caché del sistema como memoria necesariamente desperdiciada.
15. strace: descubrir qué está intentando hacer un programa
Para terminar, vamos con una herramienta algo más avanzada.
strace permite observar las llamadas al sistema realizadas por un proceso y las señales que recibe.
Resulta especialmente útil cuando una aplicación falla y no está claro qué operación está provocando el problema.
Ejecutar un programa bajo strace
strace -o traza.log ls /tmp
El comando ejecuta ls /tmp y guarda la traza en traza.log.
Examinar operaciones relacionadas con archivos
strace -e trace=%file -o traza.log ls /tmp
Esto restringe la traza a llamadas relacionadas con operaciones sobre archivos y rutas.
Podemos encontrar intentos de acceso que terminan con errores como:
ENOENT
EACCES
ENOENTsuele indicar que una ruta o elemento solicitado no existe.EACCESindica un problema de acceso o permisos.
Seguir un proceso existente
sudo strace -p 1234
Permite intentar adjuntarse al proceso con PID 1234.
Seguir procesos hijos
strace -f -o traza.log ./aplicacion
La opción -f permite seguir procesos creados mediante mecanismos como fork.
¿Cuándo lo utilizo?
Cuando una aplicación no encuentra archivos, tiene problemas de permisos o falla sin proporcionar información suficiente en sus logs.
Hay que utilizarlo con criterio en producción. Las trazas pueden contener información sensible y la instrumentación puede afectar al rendimiento del proceso.
Laboratorio práctico: un pequeño diagnóstico Linux
Después de repasar estos comandos, vamos a combinarlos en una práctica sencilla.
La idea es simular algunas situaciones habituales sin modificar configuraciones del sistema.
Paso 1. Preparar el entorno
LAB=$(mktemp -d)
echo "$LAB"
Creamos un directorio temporal para nuestras pruebas.
Paso 2. Iniciar un proceso de prueba
sleep 300 &
PID=$!

echo "PID del proceso: $PID"
Tenemos un proceso que permanecerá activo durante aproximadamente cinco minutos.
Paso 3. Localizarlo
ps -p "$PID" -o pid,ppid,stat,cmd
También podemos buscarlo con:
pgrep -af 'sleep 300'
Paso 4. Comprobar su existencia
kill -0 "$PID" && echo "El proceso existe y es accesible"
No hemos detenido el proceso.
Paso 5. Crear un archivo abierto y después eliminar su nombre
Vamos a reproducir, a pequeña escala, el problema de los archivos borrados que siguen abiertos.
python3 - "$LAB" <<'PY'
import os
import sys
import time

ruta = os.path.join(sys.argv[1], "archivo_abierto.log")

with open(ruta, "w") as archivo:
    archivo.write("Archivo de prueba\n")
    archivo.flush()
    os.unlink(ruta)
    print(f"PID: {os.getpid()}", flush=True)
    time.sleep(60)
PY
Mientras este programa permanece ejecutándose, podemos abrir otra terminal y consultar:
sudo lsof +L1
Deberíamos poder localizar el archivo eliminado que el proceso Python mantiene abierto, siempre que tengamos visibilidad sobre el proceso y el sistema de archivos.
Después de sesenta segundos, el programa termina y libera el descriptor.
El ejemplo permite entender por qué borrar un archivo no siempre libera inmediatamente el espacio que ocupaba.
Paso 6. Comprobar las rutas de red
ip -br addr
ip route
ip route get 8.8.8.8
Podemos observar las interfaces, las rutas existentes y la ruta que seleccionaría el kernel para ese destino.
Paso 7. Revisar los servicios y temporizadores
systemctl --failed
systemctl list-timers --all
No modificamos nada: simplemente examinamos el estado del sistema.
Paso 8. Terminar el laboratorio
Si el proceso sleep sigue activo:
kill "$PID" 2>/dev/null
Y para eliminar el directorio temporal, desde el shell donde definimos LAB:
printf 'Directorio a eliminar: %s\n' "$LAB"
Tras verificar la ruta:
[ -n "$LAB" ] && [ -d "$LAB" ] && rm -ri -- "$LAB"
La opción -i nos permite confirmar la eliminación.
Para terminar
Algo que he aprendido administrando Linux es que conocer comandos no significa memorizar cientos de opciones.
Lo realmente útil es saber qué herramientas tenemos disponibles y recordar que muchas permiten hacer bastante más de lo que parece a primera vista.
Cuando un servidor falla, no siempre necesitamos instalar otra aplicación de diagnóstico. A veces basta con combinar ss, ip, journalctl, lsof o strace para empezar a comprender qué está ocurriendo.
Y, por supuesto, ninguna herramienta sustituye al análisis. Un comando puede mostrarnos qué proceso ocupa un puerto o qué archivo no puede abrir una aplicación, pero interpretar esa información sigue siendo nuestro trabajo.
Con esta segunda entrega cerramos un primer recorrido por la cara oculta de la consola. Seguro que todavía quedan muchas opciones por descubrir.