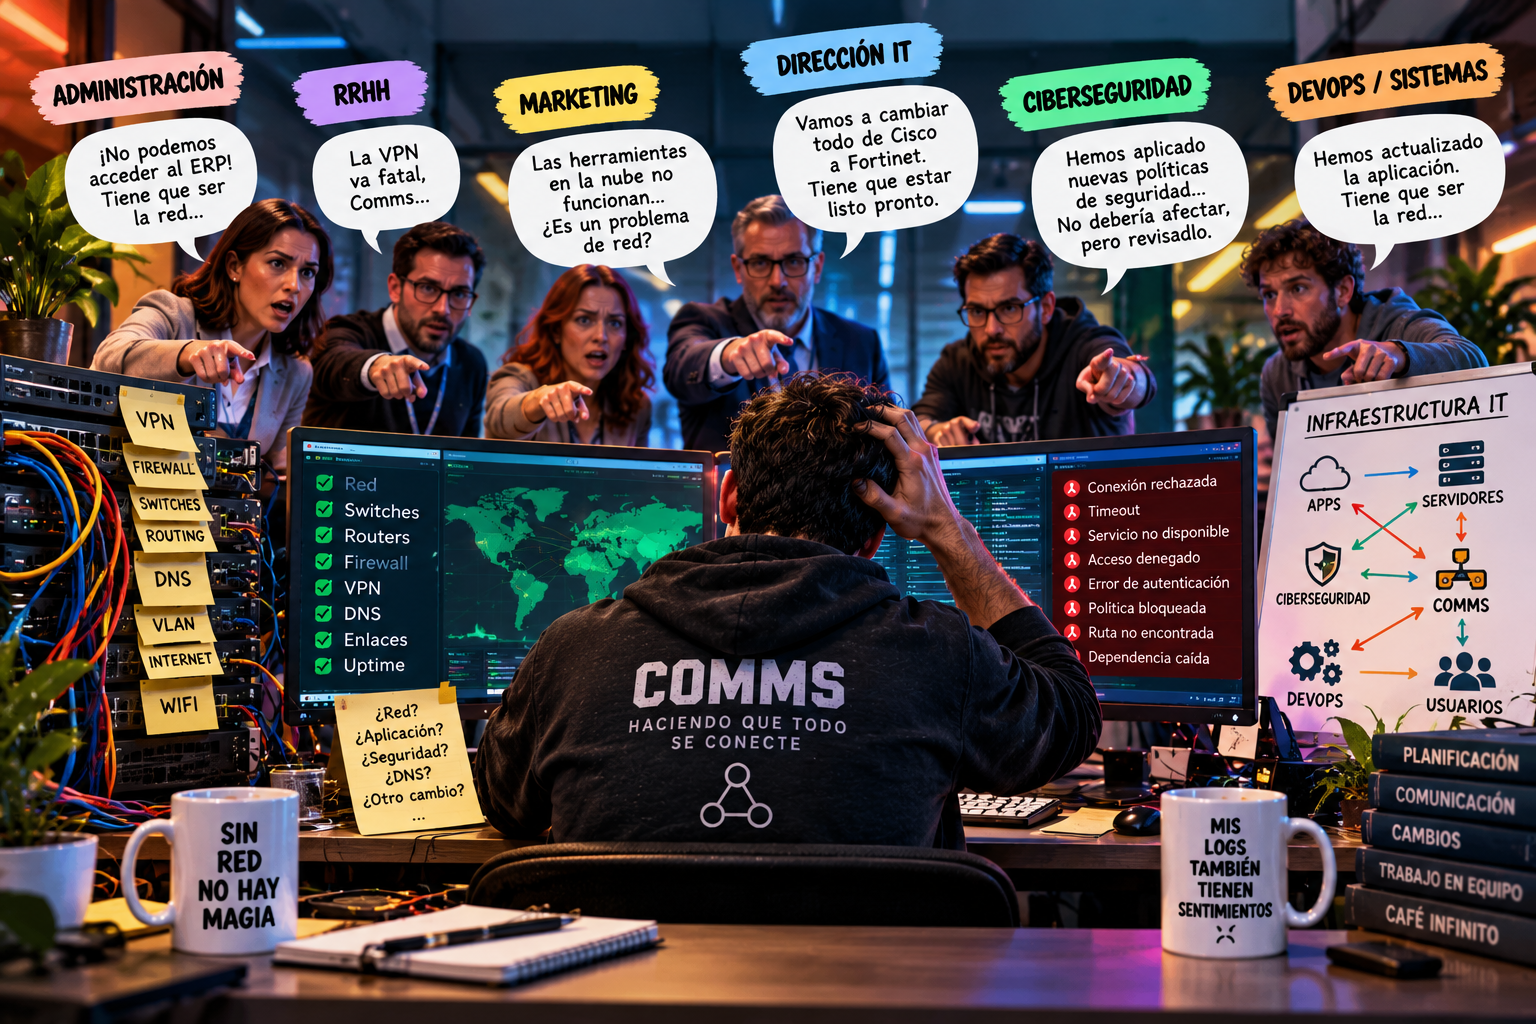
Hay una frase que, si trabajas en Comunicaciones, probablemente hayas escuchado más veces de las que te gustaría:
«Me gustaría saber qué están haciendo los de Comms, porque últimamente tenemos muchos problemas de conexión».
La puedes escuchar en Administración, Recursos Humanos, Marketing o mientras esperas un café junto a recepción.
A veces la dicen sin saber que tienes a un técnico de Comunicaciones sentado justo detrás.
Y tú, que llevas toda la mañana revisando logs, comprobando interfaces, analizando tráfico y descartando problemas en la infraestructura, te quedas pensando:
«Si yo te contara...»
Porque hay algo que desde fuera no siempre se entiende: no todo lo que parece un problema de red tiene su origen en la red. Y, sobre todo, no todos los cambios que afectan a las comunicaciones los realiza el equipo de Comms.
En mi anterior entrada hablaba de los técnicos invisibles, de los tickets urgentes y de esas incidencias de conectividad que terminan siendo una contraseña incorrecta.
Pero hoy quiero ir un poco más allá.
Porque existe otra realidad, bastante menos divertida cuando te toca vivirla, y es que dentro del propio departamento de IT también tenemos nuestros pequeños reinos, nuestras decisiones estratégicas y nuestras guerras silenciosas.
Y cuando algo sale mal, alguien tiene que dar explicaciones.
Adivinad quién suele recibir la primera llamada.
1. La red es culpable hasta que se demuestre lo contrario
Imaginemos una mañana de lunes.
En Administración no pueden acceder al ERP. Recursos Humanos se queja de que una aplicación tarda demasiado. Marketing dice que una herramienta en la nube ha dejado de funcionar y desde recepción aseguran que «Internet va fatal».
En cuestión de minutos, todos los problemas se convierten en uno solo:
«Tenemos una incidencia general de red».
Se abre un ticket de prioridad crítica y comienza el espectáculo.
Comms empieza a revisar.
Los switches están operativos. Los enlaces no presentan errores. El routing funciona. No hay interfaces saturadas, las VLAN están correctamente configuradas y los equipos responden.
Hacemos ping, traceroute, revisamos sesiones, comprobamos DNS y analizamos por dónde circula el tráfico.
Aparentemente, todo está correcto.
Pero alguien insiste:
—Tiene que ser la red, porque ayer funcionaba.
Una afirmación técnicamente impecable, por supuesto. Si ayer funcionaba y hoy no, necesariamente tiene que haberse roto un switch.
Y entonces, después de media hora de investigación, aparece un dato interesante.
El viernes por la tarde, otro departamento modificó una política de seguridad.
Nadie informó a Comms.
Nadie actualizó la documentación.
Nadie relacionó aquel cambio con las aplicaciones que ahora están fallando.
Pero el ticket sigue asignado a Comunicaciones.
Porque, al parecer, además de mantener la red, también debemos desarrollar capacidades de adivinación.
2. Dirección de IT: «Vamos a cambiarlo todo»
Otro clásico de las grandes organizaciones son las decisiones tecnológicas que llegan desde arriba.
Un buen día, alguien de la dirección de IT anuncia:
—Vamos a renovar la infraestructura. Dejamos Cisco y nos pasamos a Fortinet.
Perfecto.
Cambiar de fabricante puede tener todo el sentido del mundo. Hay contratos, presupuestos, estrategias de seguridad, necesidades de integración y decisiones técnicas que deben evaluarse.
El problema aparece cuando una migración de infraestructura se trata como si estuviéramos cambiando las sillas de la oficina.
Porque sustituir equipos de red no consiste únicamente en retirar una caja, instalar otra y conectar los mismos cables.
Hay configuraciones, políticas, VLAN, protocolos de routing, VPN, alta disponibilidad, monitorización, compatibilidades y decenas de pequeños detalles que llevan años funcionando de una determinada manera.
Y en muchos casos existen configuraciones heredadas que nadie recuerda por qué están ahí.
Hasta que las quitas.
Entonces todo el mundo recuerda perfectamente para qué servían.
Pero la decisión ya está tomada, el presupuesto aprobado y el calendario establecido.
—¿Cuánto tardáis en migrarlo?
—Depende. Tenemos que analizar la infraestructura, preparar configuraciones, probar compatibilidades y planificar el cambio.
—Bueno, pero si es cambiar unos equipos por otros...
Claro.
Igual que cambiar el motor de un avión en pleno vuelo. Total, los dos tienen tornillos.
Y cuando después de una migración aparece un comportamiento inesperado, la pregunta vuelve a ser la misma:
«¿Qué han hecho los de Comms?».
Pocas veces escuchamos: «¿Se planificó correctamente el proyecto? ¿Teníamos tiempo suficiente para las pruebas? ¿Participaron todos los equipos afectados?».
No. Es mucho más sencillo buscar un culpable que revisar cómo se tomó una decisión.
3. Ciberseguridad: los chicos cool también tocan cosas
Luego tenemos al departamento de Ciberseguridad.
Y antes de que alguno afile el teclado, dejemos algo claro: su trabajo es absolutamente necesario.
Sin buenas políticas de seguridad, controles de acceso, segmentación, monitorización y protección frente a amenazas, una infraestructura puede convertirse en un auténtico coladero.
El problema no es Ciberseguridad.
El problema aparece cuando determinadas decisiones se toman de forma aislada y sus efectos recaen sobre sistemas que mantienen otros equipos.
Porque, seamos sinceros, en algunas empresas Ciber tiene cierto aire de departamento VIP.
Son los chicos cool de IT.
Hablan de Zero Trust, hardening, compliance, EDR, SIEM y arquitecturas seguras. Se reúnen con dirección, preparan informes de riesgos y anuncian nuevas políticas corporativas.
Mientras tanto, Comms sigue en su rincón, con sus switches, sus routers y sus diagramas de red.
Hasta que un buen día llega una nueva política de seguridad.
Se modifican reglas en el firewall, se restringen puertos, se cambia el comportamiento del proxy o se endurecen los controles de acceso.
Sobre el papel, todo muy seguro.
Pero nadie ha comprobado que cierta aplicación corporativa utiliza una comunicación específica entre dos servidores.
O que un sistema heredado necesita acceder a un servicio que acaba de quedar bloqueado.
O que determinada integración depende de una excepción que lleva años funcionando.
Resultado: aplicaciones que dejan de conectar, sesiones que se interrumpen y usuarios que llaman al soporte.
¿Y quién recibe la incidencia?
Exactamente.
Comunicaciones.
—No llegamos al servidor.
—Vamos a comprobarlo.
Revisamos rutas, interfaces, conectividad y capturas de tráfico.
Hasta que descubrimos que existe una regla nueva bloqueando las conexiones.
—¿Quién ha cambiado esta política?
—Ah, sí, fue una actualización de seguridad.
—¿Y se avisó a Comms?
Silencio administrativo.
Que conste que aplicar controles de seguridad es imprescindible. Pero una política mal coordinada puede romper servicios perfectamente legítimos.
La seguridad y la disponibilidad tienen que trabajar juntas.
Porque de poco sirve tener una aplicación extraordinariamente protegida si nadie puede utilizarla.
Y tampoco sirve permitirlo todo simplemente para evitar incidencias.
Hay que encontrar el equilibrio. Preferiblemente antes de pulsar el botón de aplicar cambios en producción.
4. DevOps, servidores y el maravilloso mundo de «yo no he tocado la red»
Y todavía nos queda otra parte de la familia IT.
Los equipos de Sistemas, Desarrollo, DevOps y plataformas.
Gente que administra servidores, despliega aplicaciones, automatiza procesos, mantiene contenedores y consigue que una cantidad impresionante de servicios funcione sin intervención manual.
Un trabajo que conozco y valoro especialmente.
Pero aquí también pasan cosas.
Imaginemos que un equipo realiza un despliegue en producción.
Se actualiza una aplicación, se modifica una configuración, se cambia el puerto de escucha de un servicio o se altera una variable de entorno.
El despliegue finaliza.
La aplicación arranca.
Todo parece correcto.
Hasta que los usuarios empiezan a llamar.
—No podemos acceder a la plataforma.
Y entonces alguien lanza la frase mágica:
«Nosotros solo hemos actualizado la aplicación. Tiene que ser un problema de red».
Por supuesto.
Porque una aplicación que devuelve un error 503, un servicio que ya no escucha en el puerto esperado o un contenedor que ha perdido conectividad con su base de datos deben ser, necesariamente, responsabilidad del switch del segundo piso.
Comms vuelve a investigar.
La resolución DNS funciona.
La conexión llega hasta el balanceador.
Los paquetes circulan correctamente.
Pero el servicio de destino no está disponible.
Después de revisar configuraciones y comparar el estado anterior al despliegue, aparece el problema.
Una modificación en producción cambió la forma en que se comunica la aplicación con otro componente.
No había fallado la red corporativa.
Había cambiado el comportamiento de un servicio.
Ahora bien, conviene ser justos: también existen despliegues en los que una configuración de routing, una política de firewall, el DNS o un balanceador son realmente responsables.
Por eso las incidencias deben investigarse entre todos.
Lo que no tiene demasiado sentido es que cada equipo descarte su responsabilidad antes de empezar las comprobaciones.
O que un cambio perfectamente conocido para quien lo ejecutó sea un misterio absoluto para quienes tienen que diagnosticar sus consecuencias.
Si modificamos producción, dejemos constancia de qué hemos cambiado.
Y, a ser posible, avisemos a los demás.
Parece una idea sencilla.
En algunas organizaciones, casi revolucionaria.
5. Comms no es el departamento de telepatía
Con los años he llegado a una conclusión bastante simple.
En una empresa moderna, la infraestructura IT está tan interconectada que resulta absurdo pensar que cada departamento trabaja de manera completamente independiente.
Una aplicación necesita servidores, servicios de autenticación, resolución DNS, comunicaciones y controles de seguridad.
Una VPN puede depender de certificados, políticas de acceso, directorios corporativos y configuraciones de distintos fabricantes.
Un servicio puede estar disponible desde una sede y fallar desde otra por motivos que van mucho más allá de que exista o no conexión física.
Por eso una incidencia no siempre pertenece a un único departamento.
Y ahí es donde entra algo que, por desgracia, no siempre se practica suficientemente: la coordinación.
No se trata de crear reuniones interminables para decidir si podemos cambiar una dirección IP.
Se trata de tener un procedimiento razonable de gestión de cambios, informar a los equipos afectados, evaluar dependencias y disponer de un plan para volver atrás cuando algo no salga como esperamos.
También se trata de compartir información.
Si Ciber modifica una política, Comms debería conocer los cambios que afectan a sus servicios.
Si DevOps despliega una nueva versión, Sistemas y Comunicaciones deberían poder consultar qué se ha modificado cuando aparezca una incidencia.
Si la dirección decide renovar una infraestructura, quienes tienen que operarla deberían participar en su diseño y planificación.
Y si Comms cambia rutas, VLAN o configuraciones de red, también debe informar a los demás.
Porque la responsabilidad funciona en ambas direcciones.
No necesitamos encontrar un culpable. Necesitamos encontrar la causa.
Aunque reconozco que esto último resulta bastante menos emocionante que convocar una reunión urgente para preguntar qué demonios están haciendo los de Comunicaciones.
6. Al final, seguimos siendo el equipo al que todos llaman
No quiero que esta entrada se interprete como una guerra entre departamentos.
He trabajado con profesionales excelentes de Ciberseguridad, Sistemas, Desarrollo y DevOps. Personas que conocen perfectamente la complejidad de una infraestructura y con las que da gusto resolver problemas.
Y también sé que en Comms metemos la pata.
Una ruta mal anunciada, una ACL demasiado restrictiva, un trunk configurado incorrectamente o una modificación de BGP pueden provocar problemas serios.
Cuando ocurre, toca asumirlo, corregirlo y aprender.
Así funciona nuestro trabajo.
Lo que resulta agotador es convertir sistemáticamente a un departamento en responsable de cualquier incidencia que tenga la palabra «conexión» en su descripción.
A veces el problema está en la red.
A veces está en una aplicación, en un cambio de seguridad, en un despliegue, en un certificado caducado o en una decisión técnica que se tomó varios niveles por encima de quienes ahora intentan arreglar el problema.
Y muchas veces la solución aparece cuando dejamos de defender nuestro pequeño territorio y empezamos a investigar juntos.
Porque IT no debería ser una colección de departamentos intentando demostrar que el problema es del vecino.
Debería ser un equipo trabajando para que la empresa pueda seguir funcionando.
Mientras tanto, nosotros seguiremos revisando interfaces, tablas de routing, capturas de tráfico y logs.
Y si mañana escucho junto a la máquina de café aquello de:
«No sé qué estarán haciendo los de Comms, porque la red vuelve a fallar...».
Seguramente sonreiré, cogeré mi café y volveré a mi sitio.
Porque acaba de llegar otro ticket urgente.
Y, curiosamente, parece que alguien cambió una política de seguridad anoche.
Sin avisar.
Otra vez.